 Figma
 Adobe XD
 Sketch
 Discord
 Twitter
 GitHub


DeepSeek Super-Agent : qu’est-ce que c’est, comment ça marche et ce qui manque encore24 min read
Reading Time: 14 minutesOuvrez trois agents de codage à la fois et vous ressentirez le problème. On attend une décision, on a fini il y a vingt minutes, et on a déjà oublié lequel a le correctif d’authentification. L’équipe Harness de DeepSeek lui a attribué un chiffre : d’après son expérience, une personne ne peut suivre que trois à cinq séances d’agents actifs à la fois. Passé ce stade, le modèle ne constitue plus le goulot d’étranglement. Tu es.
Le 31 octobre 2026, l’équipe a publié un article de conception pour ce qu’elle appelle un super-agent et a mis en open source un prototype nommé dsh-superagent. Il s’agit d’un agent de codage proactif pour un référentiel GitHub. Une session de routeur de longue durée parle aux gens et distribue le travail, et chaque demande acceptée obtient sa propre session de travail qui se termine par une pull request ou une question. Le référentiel a dépassé 12 000 étoiles en deux jours environ. Son README indique clairement qu’il s’agit d’un code de recherche et non d’un produit officiel DeepSeek.
Ce guide est destiné aux ingénieurs et aux chefs d’équipe qui souhaitent savoir ce que fait le prototype, comment fonctionne la conception du routeur et du travailleur, ce que les chiffres de référence prouvent et ne prouvent pas, et ce qu’il faut vérifier avant de le pointer vers un référentiel réel.
Une note avant les détails. La réponse d’un travailleur pour « corriger ce bug » est une demande d’extraction, et GitHub est un bon endroit pour cela. Le reste de ce que les agents produisent autour du code est plus difficile à situer : la description de la cause profonde, le résumé du test, le tableau de comparaison demandé par un évaluateur.AgentGrid.ioest un espace de travail partagé dans lequel les personnes et les agents IA créent, modifient et partagent des documents, des applications et des fichiers, avec une version en direct, une attribution et un historique. Nous revenons là où cela se situe vers la fin.
Qu’est-ce que le DeepSeek Super-Agent ?
Deux choses sont apparues ensemble. Le premier est un long article de conception, « Explorer la conception des super-agents : vers un système d’agents plus autonomes ». L’équipe Harness l’a écrit en chinois et a publié une version anglaise traduite automatiquement sur X le 1er novembre. Elle a été vue plus de 2,2 millions de fois. Le deuxième est le code :deepseek-ai/dsh-superagent-prototype, publié sous licence MIT.
Explorer la conception des super-agents : vers un système d’agents plus autonome
– Harnais DeepSeek (@DeepSeekHarness)1 novembre 2026
Ce n’est pas un nouveau modèle. dsh-superagent est un ensemble pourDeepSeek Harnais, le faisceau d’agents open source de DeepSeek, que la société décrit comme étant en avant-première publique dans le monde entier. Le bundle surveille un référentiel GitHub et, si vous l’activez, les discussions Feishu. Lorsqu’une personne figurant sur une liste autorisée demande du travail à l’agent, celui-ci ouvre un élément de travail, l’exécute dans sa propre session et son propre répertoire, et répond dans la conversation d’origine. Un panneau Web montre uniquement ce dont une personne a besoin.
Le nom est plus simple qu’il n’y paraît. Cui Tianyi, du département produit de DeepSeek et l’un des derniers réviseurs de l’article, a expliqué dans un article de Zhihu que « super » signifie en exposant par rapport à l’indice. Un super-agent ajoute une couche au-dessus de l’agent qui fait le travail, à l’opposé d’un sous-agent, qui en ajoute une en dessous. Il ne s’agit pas d’une affirmation d’une intelligence supérieure.
Le README s’ouvre sur un avertissement qui mérite d’être lu dans son intégralité : « Prototype de recherche à titre de référence uniquement, pas un produit officiel DeepSeek. » Il ajoute qu’une grande partie de l’ingénierie a été réalisée par des agents de codage, que le code peut contenir des bogues et que certaines conceptions de l’article sont des orientations pour des travaux futurs et ne sont pas implémentées.
| En un coup d’œil | dsh-superagent-prototype |
|---|---|
| Qu’est-ce que c’est | Un agent de codage proactif pour un référentiel GitHub, présenté sous la forme d’un bundle DeepSeek Harness |
| Statut | Prototype de recherche, « logiciel non prêt pour la production » selon le README |
| Licence | MIT |
| Langue | TypeScript |
| Écoute | Problèmes GitHub, demandes d’extraction, commentaires et CI. Les discussions Feishu sont facultatives |
| Créé | 31 octobre 2026. Plus de 12 000 étoiles et 1 200 fourchettes d’ici le 2 novembre |
| Comment le configurer | Demandez à votre agent de codage de lire SETUP.md et de le configurer avec vous |
Une autre baisse de DeepSeek : dsh-superagent
Un cadre d’agent qui fonctionne sur les problèmes GitHub et les PR d’un dépôt avec de nombreux agents en parallèle, conçu pour attirer le moins d’attention humaine possible tout en offrant autant de valeur que possible.
-Leandro von Werra (@lvwerra)31 octobre 2026
Pourquoi DeepSeek dit-il que le goulot d’étranglement est l’attention humaine ?
L’article part d’un simple constat. Au cours de l’année écoulée, les agents de codage sont devenus suffisamment performants pour qu’une seule tâche soit limitée par le modèle. Mais une fois que vous exécutez plusieurs tâches à la fois, la limite se déplace vers vous. Chaque session est isolée, vous basculez donc entre elles manuellement et gardez une trace de ce que chacun sait. L’installation d’une CLI, d’un MCP ou d’un connecteur de discussion sur une session locale lui permet d’être informé des nouveaux événements, mais elle bloque toujours les commandes longues, mélange les contextes de différentes tâches et s’arrête lorsque votre ordinateur portable est en veille.
La réponse de DeepSeek est d’arrêter de traiter la session comme l’unité que vous gérez. Il énumère quatre traits qu’un super-agent devrait avoir :
- Continu.Vous lui parlez là où vous travaillez déjà, par exemple dans le chat ou dans les commentaires GitHub, et il se comporte comme un seul agent. Si vous demandez le plan A dans le chat et passez au plan B dans un commentaire de pull request, cela suit.
- Productif.Il exécute plusieurs tâches complexes en parallèle et prend l’instruction suivante avant la fin de la dernière.
- Proactif.Il surveille les événements, agit sur ce qui mérite d’être traité et reste silencieux autrement.
- Persistant.Il reste en ligne et récupère des échecs sans que vous le redémarriez.
Les auteurs soutiennent qu’aucune boucle ReAct ne peut offrir les quatre, les qualités doivent donc provenir de l’architecture autour du modèle. C’est le véritable sujet de l’article, et l’explication visuelle ci-dessous, partagée par Hesam, est un moyen rapide de voir l’ensemble du design sur une seule page.
voici une explication visuelle de l’article de DeepSeek sur Super-Agent :https://t.co/bByKYDoq6h pic.twitter.com/BhzbBh3NrP
– ℏεsam (@Hesamation)1 novembre 2026
Comment fonctionne la conception du routeur et du travailleur ?
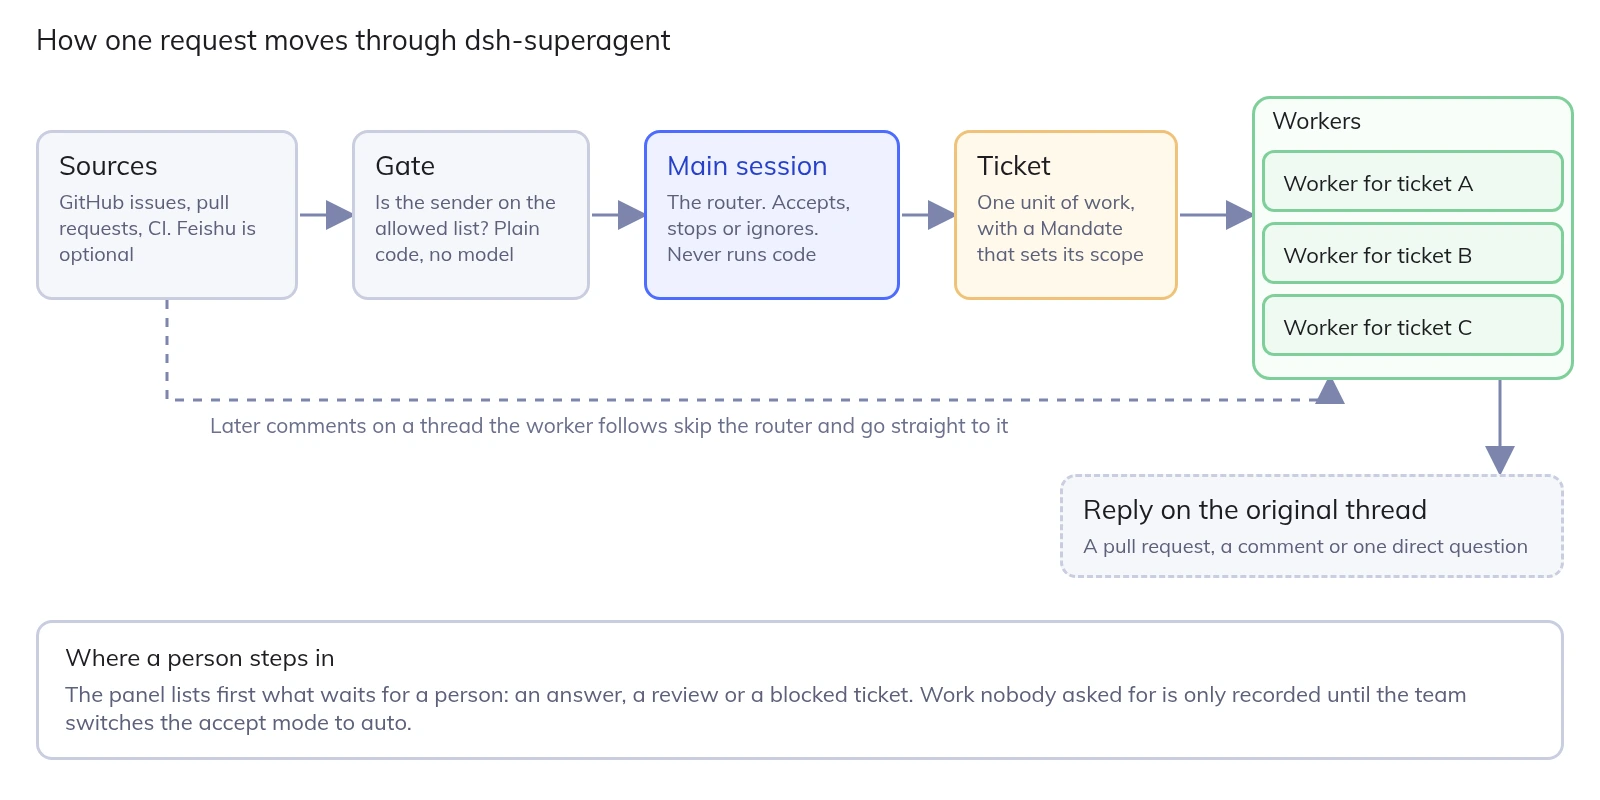
Pensez à un bon responsable de l’ingénierie qui n’écrit jamais de code en stand-up. Lerouteurest une session de longue durée qui reçoit tous les messages de tous les canaux. Il n’exécute pas de tâches. Il décide de ce que demande un message, confie un nouveau travail à un travailleur et rédige chaque réponse aux personnes impliquées. L’article indique qu’il peut fonctionner sans aucun outil shell et qu’un modèle plus léger et plus rapide suffit généralement.
Unouvrierest une session distincte avec un contexte isolé et un ensemble complet d’outils, dédiés à une tâche. Les travailleurs ne parlent jamais directement aux gens. Ils signalent l’état au routeur, qui conserve les réponses d’une seule voix. Dans le prototype, chaque ticket obtient sa propre session et son propre répertoire, généralement un arbre de travail git, et le nombre de travailleurs est plafonné. La valeur par défaut est trois à la fois, réglable de 1 à 16, avec un emplacement supplémentaire laissé libre afin que le message d’une personne puisse toujours passer.
Deux détails en font plus qu’une file d’attente de tâches.
Les suivis ignorent le routeur.Une fois qu’un travailleur possède une pull request ou un fil de discussion, il s’abonne à ce fil. Les commentaires ultérieurs y vont directement, sans appel de modèle supplémentaire au niveau du routeur. Si un commentaire s’avère porter sur autre chose, l’employé le rend.
Les rafales sont groupées.Les déclencheurs qui arrivent au cours d’un modèle sont mis en file d’attente et sont injectés ensemble dans l’appel suivant. Les auteurs ont mesuré l’effet et nous examinons les chiffres ci-dessous.
Encore un point de contraste. L’article distingue cela d’une équipe d’agents. Dans une équipe d’agents, un responsable divise une tâche complexe en étapes et coordonne les rôles qui y travaillent, ce qui représente une lourde charge de raisonnement. Le routeur Super-agent répartit uniquement les tâches indépendantes et suit leurs relations à un niveau élevé. Cela ne décompose pas l’œuvre elle-même.
Que fait-il quand personne ne le demande ?
C’est là que la philosophie du projet devient pratique. Le premier document du référentiel énonce le principe en une ligne : accorder le moins d’attention humaine possible et donner le plus de valeur possible. Chaque message envoyé par l’agent coûte l’attention d’un collègue, il ne parle donc que lorsqu’une personne doit agir ou peut utiliser un résultat, et il n’agit que lorsqu’on lui demande ou lorsqu’une règle écrite par l’équipe le permet.
La porte qui applique cela est un code simple, pas un modèle. Il vérifie qui demande par rapport à la liste autorisée de l’équipe et enregistre la force de la demande :
| Force | Exemples tirés de la documentation | Que se passe-t-il |
|---|---|---|
| Explicite | Une personne sur la liste autorisée mentionne l’agent ou fait le suivi d’un fil de discussion qui a déjà un ticket | L’agent accepte le travail dans tous les modes |
| Inféré | Un robot sur la liste des robots de la Source, ou le suivi d’une personne non répertoriée. Un message non adressé que l’équipe a choisi de recevoir | Évalué par rapport aux règles écrites de l’équipe. Dans le mode d’observation par défaut, il est uniquement enregistré comme « accepterait » |
| Non admis | Tout autre bot, tout ce que la table d’admission ignore | Abandonné avant qu’un modèle ne soit appelé |
Ce mode d’observation est la partie que j’aime le plus. L’agent commence par enregistrer ce qu’il aurait fait, afin que l’équipe puisse lire ces enregistrements dans l’onglet Eval et élargir ses autorisations uniquement lorsqu’ils semblent corrects. Les messages, commentaires et documents cités sont traités comme des éléments d’entrée dans une décision. Ils ne peuvent pas changer ce que l’agent est autorisé à faire.
L’article de conception montre à quoi ressemble le travail proactif dans la pratique. Dans le groupe d’utilisateurs interne du harnais DeepSeek, l’équipe a configuré une stratégie de « reproduction et correction silencieuses ». Lorsque quelqu’un signale un problème ou discute d’une modification proposée, l’agent essaie de le reproduire et de trouver un correctif en arrière-plan, et il ne fournit un résultat qu’après avoir confirmé le problème et trouvé un correctif simple. Sinon, ça reste silencieux. L’article donne également une règle brutale pour les canaux de discussion que les auteurs disent avoir vérifiés : limiter chaque réponse à 100 mots. Sur GitHub, en revanche, les demandes d’extraction doivent être denses, avec l’arrière-plan du problème, la description de la modification et les résultats de la vérification.
Par défaut, chaque message GitHub publié par l’agent commence par la ligne « Ceci provient d’un agent automatisé, pas d’un humain ». Les équipes peuvent modifier cela, ainsi que le reste des invites.
Les chiffres de référence tiennent-ils la route ?
L’article comprend une petite expérience, et les auteurs prennent soin de la qualifier d’indicative uniquement. Quatre conceptions ont été exécutées côte à côte sur un flux de discussions de groupe et de messages CI : environ 300 messages par exécution, dont une vingtaine de demandes de travail réelles, cinq exécutions chacune. Le travail de codage a été simulé par un outil qui prend simplement du temps, de sorte que le test mesure la planification et la coordination, et non la qualité du code de chacun.
| Conception | Temps d’achèvement de la tâche, p50 / p95 (min) | Jetons de lecture du cache par exécution |
|---|---|---|
| Super-agent | 12,4 / 15,7 | 23,2 millions |
| Super-agent sans pass-through | 12,6 / 15,5 | 31,8 millions |
| Session unique avec outil de sous-agent, invite neutre | 20,4 / 29,5 | 6,1 millions |
| Session unique avec outil de sous-agent, invite de délégation | 13,8 / 29,0 | 10,8 millions |
Lisez le tableau deux fois, car le titre ne représente pas toute l’histoire. La conception du routeur a réduit le temps d’exécution de p95 à environ la moitié de celui d’une seule session, mais il a utilisé environ deux à quatre fois plus de jetons de lecture du cache. Et la ligne la plus intéressante est la deuxième : la suppression du raccourci d’intercommunication n’a pas permis de terminer les tâches plus rapidement ou plus lentement, elle a simplement permis au routeur de prendre environ 30 % de décisions en plus et de graver 37 % de jetons en plus.
D’après ce que j’ai lu, la véritable découverte se trouve dans les lignes d’une seule session. Avec une invite neutre, le modèle n’a jamais appelé de sous-agent dans aucune des cinq exécutions. Il faisait le travail lui-même, de nouveaux messages l’interrompaient sans cesse et les tâches les plus lentes prenaient 29,5 minutes. Avec une invite lui demandant de déléguer, il a délégué dans quatre des cinq exécutions, et dans l’exécution restante, le modèle a jugé le travail « petit » et l’a fait lui-même. Une seule séance dépend de l’humeur du modèle. Un routeur qui n’est pas autorisé à exécuter du code ne peut pas commettre cette erreur.
Un test de résistance distinct sur le routeur seul a augmenté le taux d’arrivée d’événements dignes de décision d’environ 1 à environ 40 par minute. Le lot moyen est passé de 1,0 à 2,8 événements, le temps par requête n’a augmenté que de 2,5 à 3,9 secondes et le temps amorti par décision a diminué de 6,4 à 1,6 secondes. Plus les événements s’accumulent, moins chacun coûte cher, jusqu’à une limite qui, selon les auteurs, dépend de la longueur du contexte et du nombre d’événements qu’un modèle peut gérer avec précision en un seul tour.
DeepSeek vient d’ouvrir son prototype de super-agent en open source. Une session de routeur parle aux gens et distribue le travail, et les travailleurs isolés exécutent des tâches en parallèle à partir des événements GitHub. Dans leur propre test, le temps d’exécution de p95 est passé de 29,5 à 15,7 minutes par rapport à une seule session utilisant des sous-agents.
La baleine est à nouveau open source.pic.twitter.com/mS4sRbHmyx
– Joufflu (@kimmonismus)1 novembre 2026
Il s’agit de résultats autodéclarés sur des travaux de synthèse. Ils montrent que l’idée de planification est bonne. Ils ne montrent pas que le prototype corrige vos bugs plus rapidement.
Que disent les proches du projet sur ses limites ?
Peu de temps après la sortie, Cui Tianyi, du département produit de DeepSeek et l’un des derniers réviseurs de l’article sur la conception, a écrit comment il percevait la conception. Son cadrage est utile car modeste. Il qualifie le compromis central de continuité entre les tâches par rapport au débit des tâches.
Sur les limites, l’avis est direct. Le prototype ne met en œuvre qu’une partie de la conception proposée. D’après son examen, DeepSeek Harness n’avait pas de mémoire à long terme intégrée entre les sessions. Et le système n’a été validé que dans un petit environnement fiable au sein de l’entreprise. La propre section des problèmes ouverts de l’article répertorie la mise à l’échelle du routeur, la mémoire sur plusieurs mois, le travail sans sessions, les limites de contexte entre les agents et la manière dont les agents isolés doivent communiquer entre eux, ainsi que la sécurité.
Que devez-vous vérifier avant de l’exécuter ?
La documentation est plus franche que la plupart des articles de lancement, et elle vaut la peine de traiter ses avertissements comme des exigences.
- Les travailleurs ont un large accès.Les deux préréglages d’autorisation, pour le routeur et pour les travailleurs, fonctionnent avec
danger-full-accessen tant qu’utilisateur du système d’exploitation de l’opérateur. Les wrappers de compte choisissent les informations d’identification GitHub que l’agent utilise, mais la documentation indique qu’il s’agit de valeurs par défaut et non d’une limite de sécurité, car un travailleur peut toujours exécuter un programme par chemin absolu ou lire votre répertoire personnel. La recommandation est un compte de système d’exploitation dédié qui contient uniquement les informations d’identification de l’agent. - Une entrée non fiable est la question de sécurité ouverte.L’article prévient que si une injection rapide ou une intrusion du serveur compromet la boucle de l’agent cloud, tous les appareils connectés pourraient être atteints et que les informations d’identification qui entrent dans le contexte du modèle peuvent fuir.
- Les humains fusionnent par défaut.L’agent n’active jamais la fusion automatique sous son propre compte. La fusion automatique nécessite la CLI d’un deuxième compte nommé dans l’invite Exigences de livraison, et les instructions par défaut l’autorisent uniquement pour les petites demandes d’extraction approuvées de moins de 200 lignes modifiées.
- Il est construit autour d’un seul référentiel.Chaque configuration surveille un seul référentiel GitHub, et Feishu, un outil de chat sur le lieu de travail courant en Chine, est l’autre source de premier ordre.
- Vous avez besoin du harnais DeepSeek et d’un fournisseur de modèles.La configuration répertorie Node.js 22.19 ou version ultérieure, pnpm, git 2.32 ou version ultérieure, tmux, Python 3.8 ou version ultérieure et GitHub CLI 2.48 ou version ultérieure. La configuration d’un fournisseur de modèles est une étape opérateur.
- Le bruit est un coût.Le document de philosophie dit de ne pas utiliser l’agent pour produire du volume. Les demandes d’extraction massives et les messages diffusés coûtent plus cher à votre équipe qu’ils ne rapportent.
Comment l’essayeriez-vous sans risquer votre référentiel principal ?
La configuration comporte de nombreuses étapes, le projet vous demande donc de laisser un agent de codage le faire avec vous. Selon le fichier README, l’agent pose une courte question à la fois, affiche le plan complet une fois, puis installe et configure tout. Une première exécution prudente ressemble à ceci :
- Choisissez un référentiel jetableet un utilisateur de machine dédié ou un compte de système d’exploitation. N’utilisez pas votre propre identifiant.
- Créez un compte GitHub distinct pour l’agent.Tout ce qu’il écrit apparaît sous ce nom.
- Ouvrez le référentiel dans votre agent de codage et collez l’invite ci-dessous.Répondez à ses questions une à la fois.
- Gardez la liste autorisée pour vouset laissez le mode d’acceptation sur observation.
- Demandez quelque chose de petit.Depuis un compte autorisé, commentez
@<agent login> <request>sur une question. Un ticket devrait apparaître sur l’aperçu du panneau dans environ une minute. - Lisez l’onglet Eval pendant une semaine.Élargissez la liste ou passez en mode automatique uniquement lorsque les enregistrements « accepteraient » semblent corrects.
Le document de philosophie du projet donne aux opérateurs quatre règles qui méritent d’être répétées : commencer de manière étroite, régler pour moins de bruit, ne pas utiliser l’agent pour produire du volume et posséder ce qu’il dit en votre nom.
Où doit aller le reste du travail de l’agent ?
Supposons qu’un travailleur passe une heure sur un test d’intégration irrégulier. La pull request est la solution. Mais l’enquête derrière, quels tests ont échoué, quelles hypothèses ont été écartées, ce que le calendrier a montré, n’appartient pas à une description de relations publiques, et c’est exactement ce que l’examinateur veut contester. Si cela ne réside que dans une réponse de chat, le prochain agent ou coéquipier repart de zéro.
AgentGrid.ioest conçu pour ce transfert. Les humains et les agents IA travaillent sur les mêmes documents, applications et fichiers en direct, avec une adresse stable, un accès contrôlé et un historique des versions. La documentation d’AgentGrid.io décrit la connexion d’un agent capable de commander en exécutantnpx @animaapp/cli@latest login. Un humain approuve le nom de l’agent, son équipe et ce qu’il peut faire : lire, écrire, partager ou publier. Après cela, les modifications apportées par l’agent apparaissent dans l’historique sous son propre nom. Le prototype n’a pas d’intégration AgentGrid.io intégrée, alors considérez-le comme un modèle à essayer avec ses travailleurs, et non comme une fonctionnalité documentée.
En pratique, le travailleur rédige son enquête sous forme de fichier Markdown, le réviseur commente une ligne du tableau, un autre assistant resserre le résumé et la pull request renvoie à une version actuelle au lieu de trois copies collées.
Pour une autre version de plusieurs personnes partageant un agent, consultez notre guide pourBots de l’équipe Grok Bot. Et si vous vous demandez ce qui se cache sous un agent hébergé, notre guide pourClaude Managed Agentsexamine la version de Anthropic de la même division du cerveau et des mains, citée dans l’article de DeepSeek.
Quand devez-vous utiliser dsh-superagent et quand autre chose ?
- Utiliser dsh-superagentpour apprendre d’une conception sérieuse et documentée, pour mener une expérience confinée sur un référentiel à faible risque, ou pour emprunter ses idées : un routeur qui n’exécute jamais de code, des tickets avec une portée déclarée, un mode observation avant le mode automatique.
- Utilisez un seul agent de codage interactiflorsque vous travaillez une tâche à la fois et que vous souhaitez piloter étape par étape. Le Super-agent est conçu pour la situation inverse.
- Utiliser AgentGrid.iolorsque le résultat est un document, un rapport ou une application que plusieurs personnes et agents doivent réviser, modifier et publier, quel que soit l’agent qui l’a produit.
Questions fréquemment posées
Qu’est-ce que le DeepSeek Super-Agent ?
Il s’agit d’un prototype de recherche nommé dsh-superagent, publié par l’équipe Harness de DeepSeek le 31 octobre 2026 sous licence MIT. Il s’agit d’un agent de codage proactif pour un référentiel GitHub. Une session de routeur de longue durée prend les requêtes et attribue chacune d’elles acceptée à sa propre session de travail, qui répond dans la conversation d’origine, généralement par une pull request.
Le DeepSeek Super-Agent est-il un produit officiel DeepSeek ?
Non. Le README l’appelle un prototype de recherche à titre de référence uniquement et non un produit officiel DeepSeek, et recommande de le réviser et de l’adapter avant de l’utiliser dans votre propre environnement. Elle n’est pas non plus identique à la version interne ni à l’implémentation décrite dans l’article de conception.
En quoi un super-agent est-il différent d’un sous-agent ?
Un sous-agent ajoute une couche sous l’agent de travail. Un super-agent ajoute une couche au-dessus. Dans cette conception, le routeur se trouve au-dessus de nombreux travailleurs, parle aux gens et répartit les tâches, tandis que chaque travailleur gère une tâche de manière isolée. Le nom concerne la position et non la revendication d’une plus grande intelligence.
Faut-il Feishu ou seulement GitHub ?
GitHub seul suffit. Feishu est une deuxième source facultative, et la documentation indique qu’un échec de configuration de Feishu désactive uniquement la source Feishu.
Est-il sûr de fonctionner sur un référentiel d’entreprise ?
Pas tel quel. La documentation indique que les travailleurs s’exécutent avec un accès complet en tant qu’utilisateur du système d’exploitation de l’opérateur et que les comptes wrapper ne constituent pas une limite d’isolement. Ils recommandent un compte de système d’exploitation dédié, un compte d’agent dédié sur GitHub, une courte liste autorisée et un mode d’observation pendant que vous apprenez comment l’agent se comporte.
Est-ce plus rapide qu’une seule session d’agent de codage ?
Dans le test simulé des auteurs, la conception du routeur a terminé les tâches les plus lentes en 15,7 minutes contre 29,5 minutes pour une seule session avec un outil sous-agent, utilisant plus de jetons. Le test a utilisé un travail de codage simulé et cinq exécutions par conception, il montre donc les avantages en matière de planification, et non la qualité du code.