 Figma
 Adobe XD
 Sketch
 Discord
 Twitter
 GitHub


 Blog


Second Brain: Uma memória compartilhada para cada agente de IA que você usa16 min read
Reading Time: 10 minutesClaude conhece sua marca. ChatGPT nunca recebi o recado. Codex está trabalhando a partir da cópia do mês passado. Toda vez que você abre um novo chat ou troca de agente, colar o briefing de novo, e cada agente acaba ficando com uma versão ligeiramente diferente da verdade. Se você trabalha com mais de um agente de IA, provavelmente acabou virando a camada de copiar e colar entre eles.
Esse foi o problema que construímos Second Brain para. Second Brain (Base de Conhecimento) é um second brain compartilhado sobre AgentGrid.io: um conjunto versionado de arquivos Markdown vinculados que sua equipe navega como um grafo e que seus agentes conectados lêem e escrevem. Você resume uma vez. Claude, ChatGPT, Codex, Cursor e os outros agentes que você conecta começam da mesma memória, cada mudança mostra quem a fez, e você decide quais pessoas e agentes podem tocá-la.
Aqui está a versão curta de como funciona: crie um cérebro, cole um prompt de configuração no agente que mais sabe, deixe que ele armazene o que sabe como documentos completos, depois aponte qualquer outro agente para o cérebro antes de começar a trabalhar. Inicie seu primeiro cérebro no AgentGrid.io e dê a cada agente a mesma memória de trabalho.
O que Second Brain AgentGrid.io?
Um Second Brain é um artefato de conhecimento sobre AgentGrid.io. Por dentro, é um pequeno repositório Git de notas Markdown , chamadas de conceitos. Cada conceito tem um cabeçalho curto (tipo, título, descrição, tags, status, quem o gerou e suas fontes) e um corpo Markdown normal. Os conceitos se conectam entre si, e esses links se tornam as linhas em um gráfico que você pode explorar no aplicativo.
Ele é feito para dois tipos de leitores ao mesmo tempo. As pessoas recebem um gráfico navegável com páginas renderizadas, fontes e uma lista “Citada por”. Agentes recebem arquivos simples com um índice em cada pasta, para que possam carregar apenas o que uma tarefa precisa, em vez de engolir o cérebro inteiro.
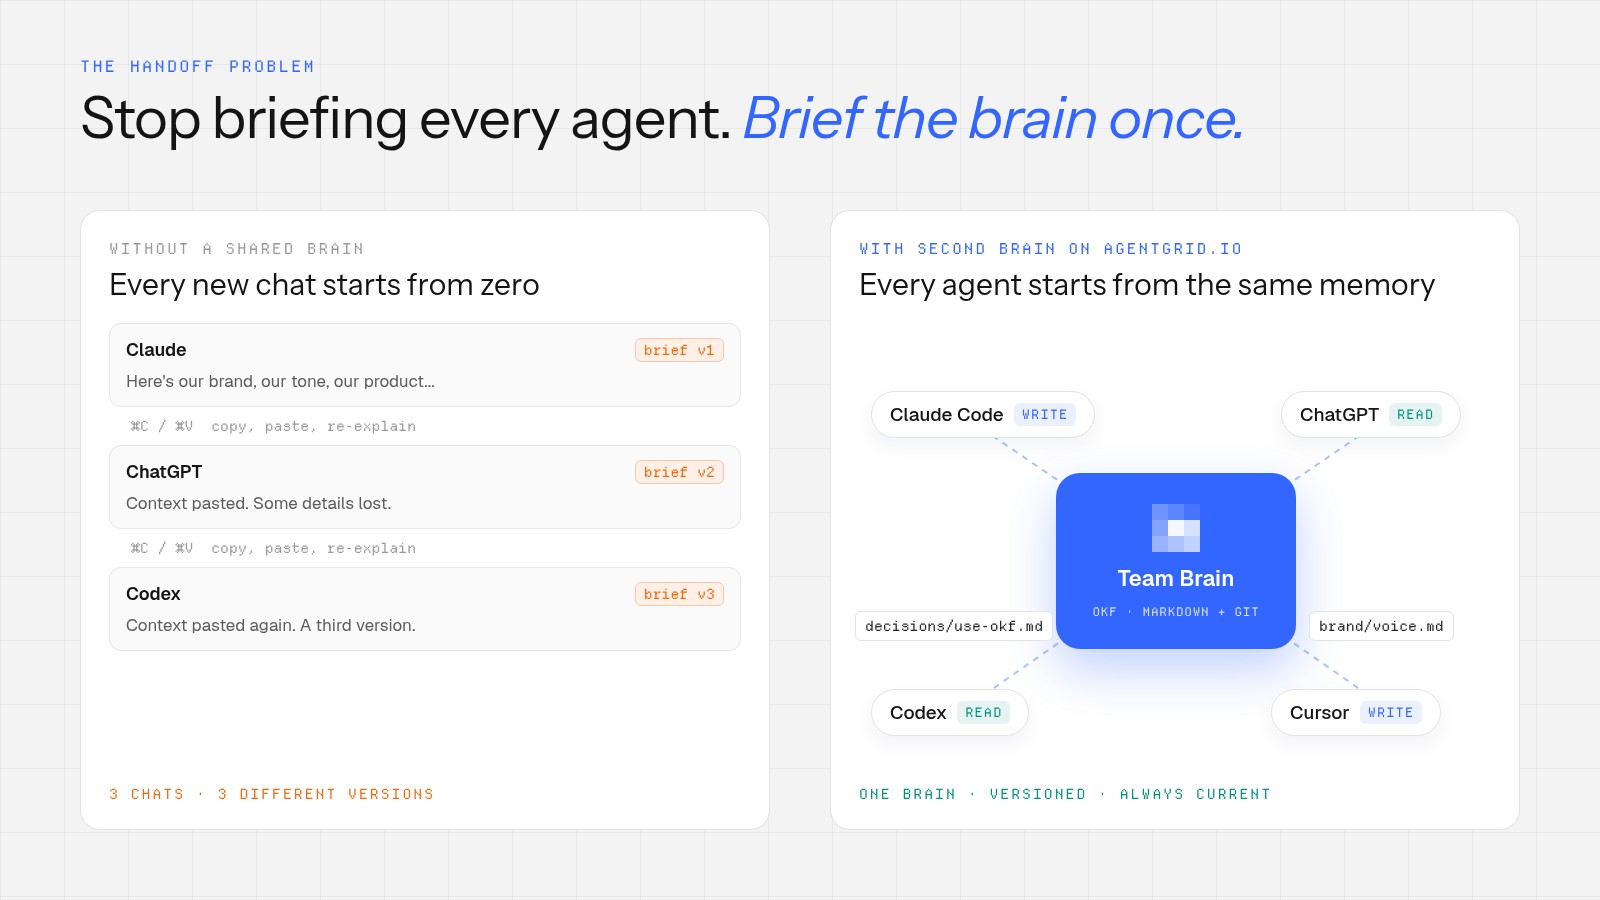
A ideia é simples: o conhecimento vive junto com o trabalho, não dentro de um único chat. No site AgentGrid.io colocamos assim: “Seus agentes são brilhantes. A transferência está quebrada.” Uma Second Brain é como você conserta a transferência.
Por que um second brain compartilhado é melhor do que rebriefar cada chat
A ideia do “second brain” começou como um hábito pessoal: capturar o que você sabe em anotações para poder encontrá-lo e reutilizá-lo depois. A IA transformou isso em algo maior. O padrão do Wiki do LLM da Andrej Karpathymostrou como um agente pode manter uma wiki interligada de Markdown páginas entre suas fontes brutas e suas perguntas, de modo que o conhecimento seja compilado uma vez e mantido atualizado. Muitas pessoas agora rodam uma versão disso em Obsidian ou em uma pasta local.
O problema começa quando o trabalho é compartilhado. A memória de chat embutida pertence a uma conta e a um produto. Um cofre local fica em um único laptop. Uma pasta de prompts é copiada para cada ferramenta e se dispersa. Quando um segundo ou terceiro agente entra, ou um colega de equipe retoma o projeto, o contexto fica para trás. Escrevi sobre essa tensão em Empresa second brain: do wiki às habilidades, tudo gira em torno do contexto. Second Brain é nossa resposta para equipes que trabalham com vários agentes todos os dias.
Um second brain compartilhado muda três coisas:
- Uma fonte de verdade. A marca, as decisões e a redação aprovada vivem em um único lugar que todo agente conectado lê primeiro.
- História visível. Cada alteração é um commit com nome e hora, então você pode ver qual agente ou pessoa alterou uma página e restaurar uma versão anterior.
- Limites claros. O acesso ao espaço de trabalho decide quem e quais agentes podem ler ou contribuir. Um link isolado não concede nada, e criar um cérebro não o publica.
Como configurar um Second Brain em cinco etapas
- Crie um cérebro. Clique em “+” → “New Brain”, ou peça ao seu agente para criar um novo cérebro de conhecimento.
- Entregue o prompt de configuração ao seu agente. Copie o prompt da caixa de diálogo e cole-o no agente que mais sabe sobre o assunto, por exemplo, Claude Código com sua pasta de marca aberta.
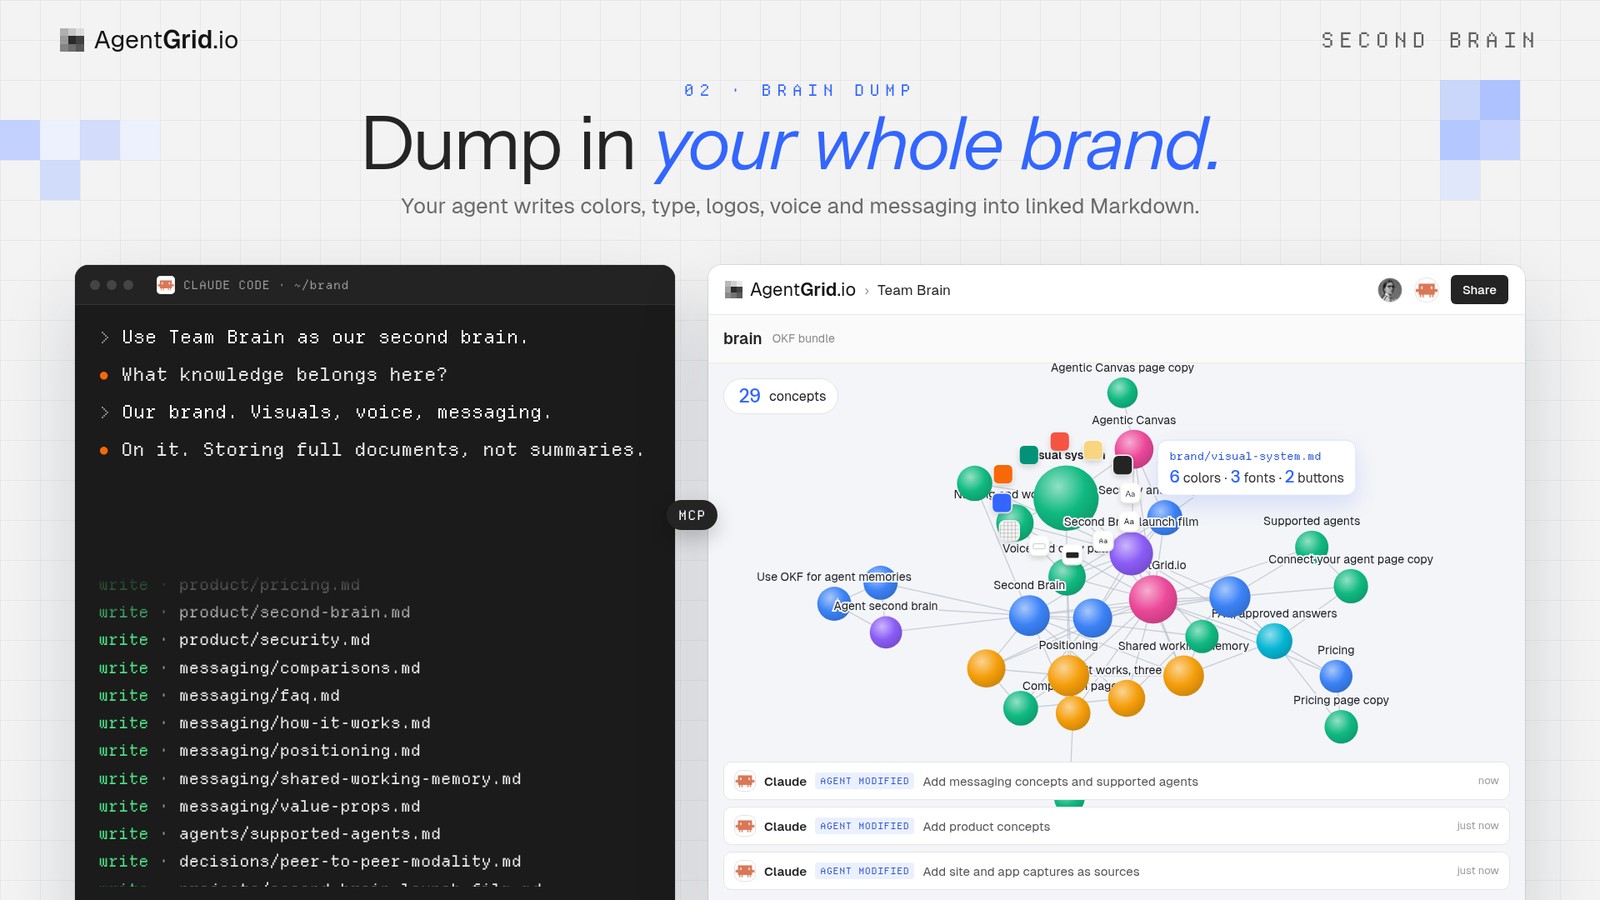
- Deixe que ele derrame o que sabe. O agente pergunta o que pertence ao cérebro e então escreve isso como conceitos interligados: cores, fontes, logotipos, voz, mensagens, decisões e as fontes por trás delas.
- Navegue e confira. Abra o cérebro, explore o gráfico, leia um conceito renderizado ou como Markdowne confirme as páginas que importam. Os conceitos permanecem marcados como “não verificados” até que uma pessoa os confirme.
- Coloque isso em prática. Peça a qualquer agente conectado que use o cérebro antes de começar. Ele lê o índice, segue os links de que precisa e trabalha a partir da sua marca real e das suas decisões, em vez de um resumo colado.
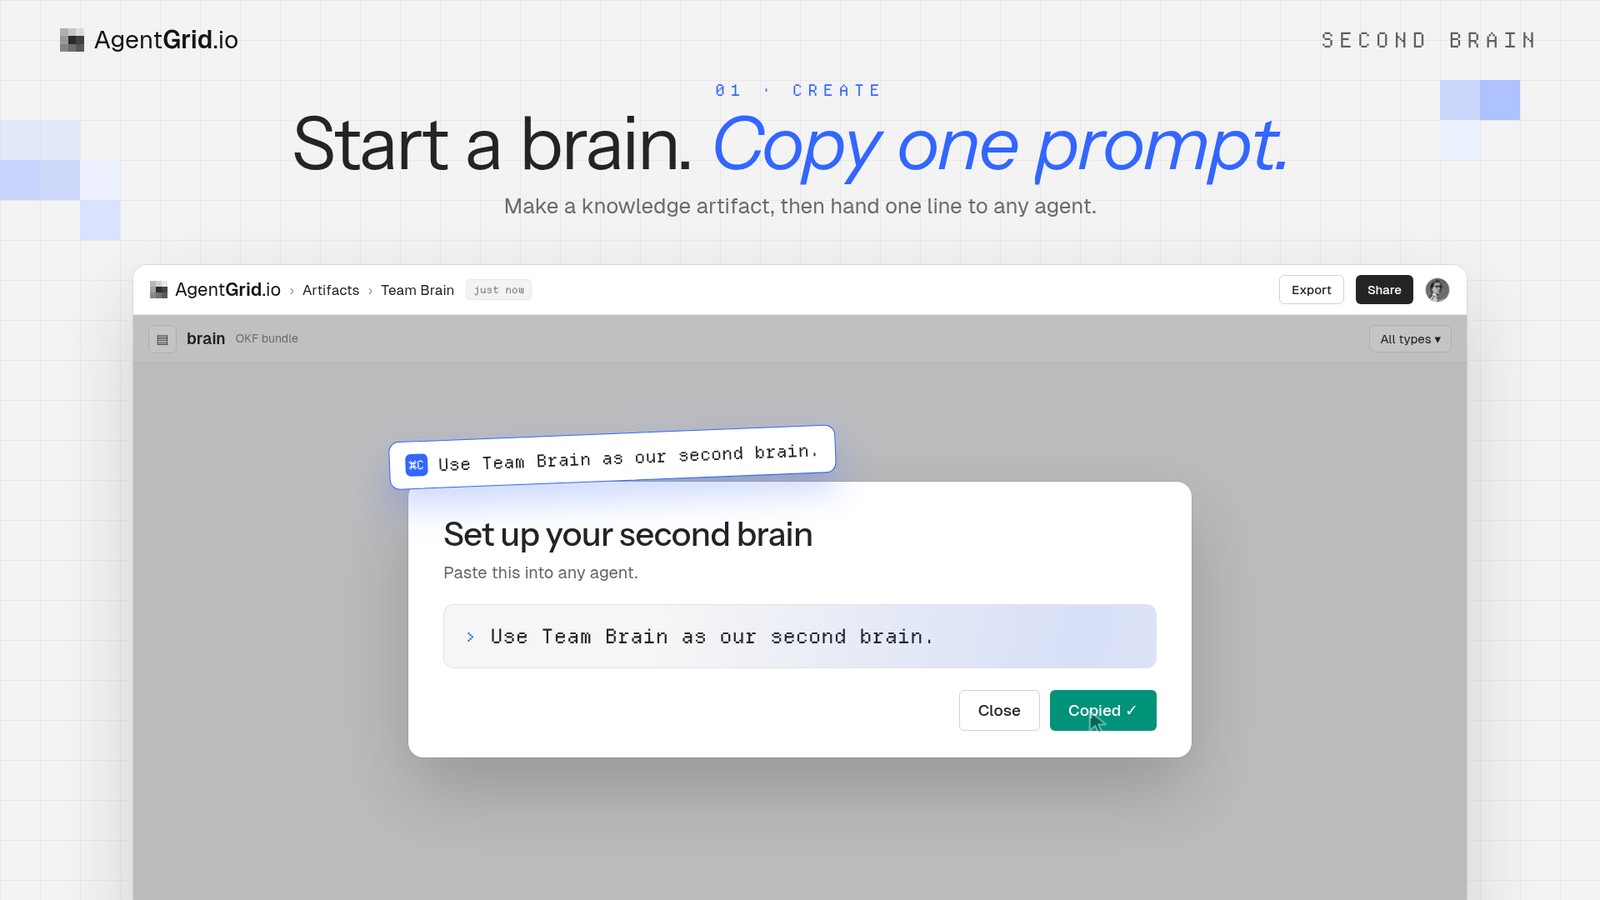
O prompt de configuração é curto de propósito. No app está lê:
Use <artifact link> for a second brain.
If it is not clear what knowledge belongs here, ask for clarification. Do not guess.
Once that's clear, dump all target knowledge documents as they are, but to use the artifact format to store them.
This is intended for sharing your knowledge with other agents, so it's important that you don't summarize, sanitize or condense the data, but to keep it full and complete so that another agent can utilize this.
Do not share credentials or secret keys to this artifact.
Duas linhas nesse estímulo fazem a maior parte do trabalho. “Peça esclarecimentos. Não adivinhe” impede o agente de encher o cérebro com suposições. “Não resuma, higienize ou condense” importa porque o próximo agente precisa do guia completo da marca ou do registro de decisão, não de um resumo de um parágrafo.
O que você vê quando abre o cérebro
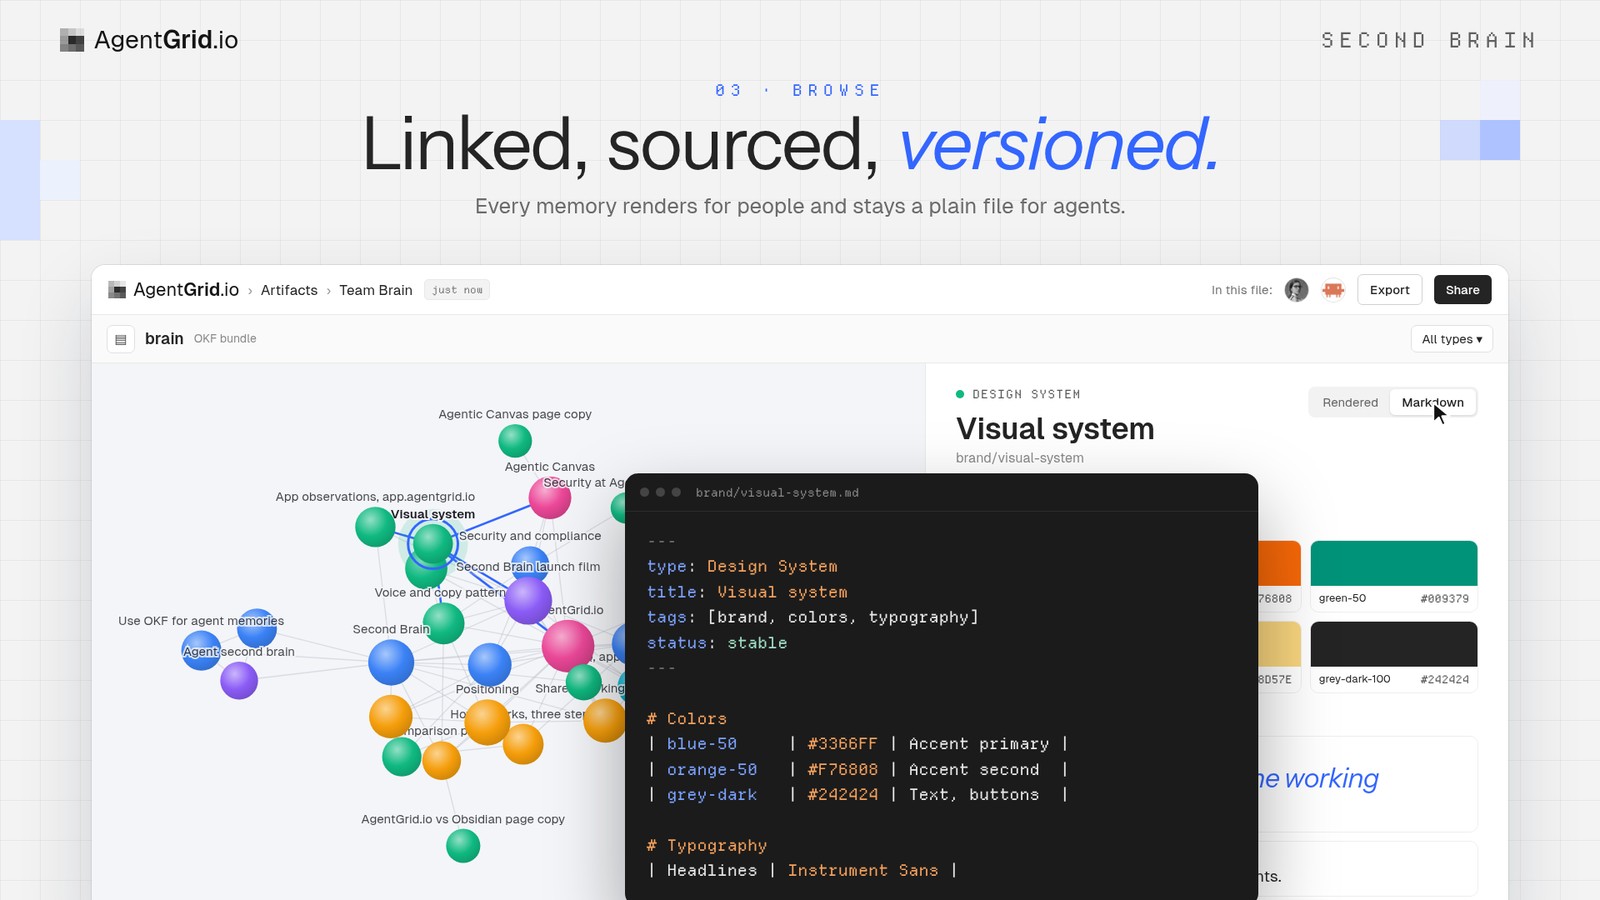
O cérebro se abre como um grafo. Cada conceito é um nó, colorido pelo tipo, e os vínculos entre os conceitos são desenhados como linhas. Selecione um nó e um painel de detalhes mostra sua descrição, tags, quem o gerou, suas fontes e os conceitos que o citam. Mude para a visualização Markdown e você estará diante do mesmo arquivo simples que seus agentes leram.
O que há dentro de um Second Brain?
Second Brain segue o Open Knowledge Format (OKF) v0.2, um formato aberto para conhecimento escrito por pessoas e agentes. Os arquivos permanecem legíveis sem banco de dados, provedor de modelo ou ferramentas especiais. Se você consegue abrir um arquivo Markdown , pode ler o cérebro e exportá-lo a qualquer momento.
| Parte | O que ela faz |
|---|---|
| Conceito | Um Markdown arquivo com um cabeçalho curto (tipo, título, descrição, tags, status, quem o gerou, fontes) e um corpo. |
| Link | Um elo normal de Markdown entre conceitos. Os links se tornam as linhas no gráfico e a lista “Citado por”. |
| Índice | Uma index.md em cada pasta. Os agentes a leem primeiro, então carregam apenas o que a tarefa precisa. |
| Log | Um log.md ultrapassado do que mudou e por quê. |
| Status | “estável”, “rascunho” ou “obsoleto”, mais “não verificado” até que uma pessoa confirme o conceito. |
| História | Cada alteração é um commit versionado, atribuído à pessoa ou agente que a fez, e versões anteriores podem ser restauradas. |
O modelo por trás dele é de código aberto. Você pode lê-lo, ou executar o mesmo formato localmente, no repositório de modelos de segundo cérebro no GitHub.
O que colocar no seu primeiro cérebro
Comece com o conhecimento que vários agentes precisam repetidas vezes, e isso dói quando ele se afasta. Esses são bons primeiros cérebros:
| Cérebro | O que entra | Por que os agentes precisam disso |
|---|---|---|
| Marca e mensagens | Nomes, voz, cores, tipo, logotipos, linhas aprovadas | Anúncios, posts e páginas saem em consonância com a marca pela primeira vez |
| Sistema de design | Tokens, componentes, padrões | Protótipos usam o visual real em vez de um genérico |
| Normas de engenharia | Revise regras, decisões de arquitetura, runbooks | Agentes de codificação seguem as mesmas convenções |
| Memória do projeto | Resumo, pesquisa, decisões e resultados para um único lançamento | O próximo agente continua onde o anterior parou |
Mantenha credenciais, chaves secretas e dados pessoais fora de cada cérebro. O prompt de configuração orienta os agentes para não armazená-los, e essa é uma boa regra para as pessoas também.
Quais agentes de IA podem usar um Second Brain?
Qualquer agente ao qual você se conecta AgentGrid.io pode trabalhar com um cérebro, dentro do acesso que você lhe concede. O site lista Claude, ChatGPT, Codex, Claude Code, Cursor, Hermes, OpenClaw, Grok Bot, Instinct e Muse. Eles se conectam de maneiras diferentes, e nenhum deles precisa de uma chave API:
| Agente | Como se conecta |
|---|---|
| Claude | Instale o conector AgentGrid.io a partir do diretório do Claudee faça login |
| ChatGPT | Instale o conector a partir do diretório do conector do ChatGPTe faça login |
| Agentes de programação e autônomos (Claude Code, Codex, Cursor, OpenClaw, Hermes, Grok Bot, Instinct, Muse) | Um comando: npx @animaapp/cli@latest login, então aprove o login no seu navegador |
A lista completa de opções está no Conecte seu agente página. Você pode conectar tantos agentes quanto quiser. Cada um atua sob seu próprio nome, então o histórico mostra exatamente qual agente mudou o quê.
Como um Second Brain permanece seguro para compartilhar
Uma memória que todo agente pode ler só é útil se você confiar no que está nela e em quem pode alterá-lo. Second Brain é construída sobre as mesmas regras que todo o resto em AgentGrid.io:
- Agentes se autenticam como agentes. Um conector não fornece a um agente sua senha nem seus outros arquivos.
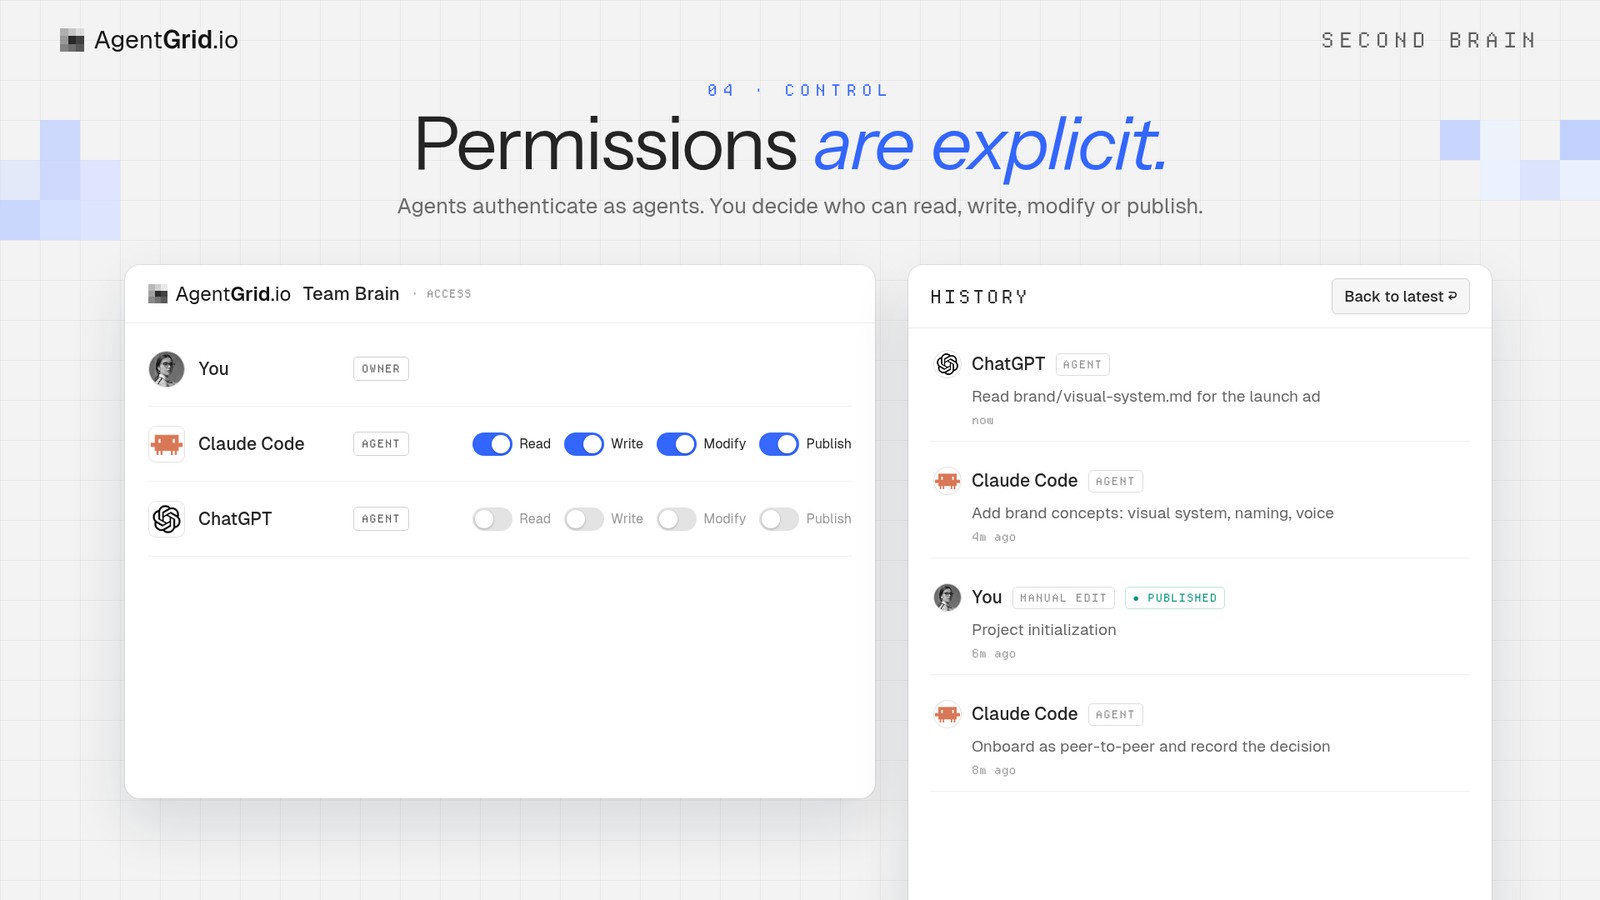
- As permissões são explícitas. O acesso ao espaço de trabalho decide quais pessoas e agentes podem ler, escrever, modificar ou publicar. Um link colado por si só não concede nada.
- Cada edição é atribuída. As mudanças de agente aparecem no Histórico com um distintivo de agente e um carimbo de data, assim como o de um companheiro de equipe.
- Qualquer versão pode ser restaurada. Se um agente escrever algo errado, faça o cérebro voltar atrás.
- Algumas ações ficam apenas para humanos. Excluir, compartilhar fora da equipe e faturar não são ações do agente.
- Compartilhar não é publicar. Um novo cérebro permanece dentro do seu espaço de trabalho até que alguém o publique explicitamente.
Second Brain comparado a aplicativos de notas, memória de chat e ferramentas de RAG
Existem boas ferramentas para cada parte desse problema. A diferença está em para quem a memória é e onde ela está.
| Abordagem | Ótimo para | Onde para |
|---|---|---|
| App de notas pessoais (Obsidian) | Capturar e vincular seu próprio conhecimento em Markdownlocal, com uma visualização em grafo e plugins | Construído em torno de uma pessoa; compartilhá-lo com outros agentes e companheiros de equipe exige uma configuração extra |
| Memória de chat integrada | Lembrando suas preferências dentro de um único assistente | Vinculado a um único produto e conta; outros agentes não conseguem lê-lo |
| Base de conhecimento vetorial ou RAG | Pesquisando grandes conjuntos de documentos por significado | Recupera blocos em vez de um conjunto curado e vinculado de páginas que as pessoas podem ler e corrigir |
| Second Brain em AgentGrid.io | Uma memória compartilhada e versionada que as pessoas navegam e agentes conectados leem e escrevem | Precisa de curadoria: um cérebro só vale quanto o que você e seus agentes colocam nele |
Eles também trabalham juntos. Se você já mantém um cofre em Obsidian, AgentGrid.io tem um Comparação justa com Obsidian Isso resume tudo como “Conhecimento pessoal para dentro. Execução compartilhada encerrada.”
Dicas para um cérebro que seus agentes realmente usam
Pergunte antes de despejar
Os melhores cérebros começam com um escopo claro. Deixe o agente perguntar o que pertence a esse lugar antes de escrever qualquer coisa, e responda em uma frase: “Nossa marca. Imagens, voz, mensagem.” Um cérebro sobre tudo é um cérebro que nenhum agente consegue navegar.
Armazene documentos completos, não resumos
Resumos parecem organizados, mas deixam de lado os detalhes que fazem o trabalho sair certo: o valor exato em hexadecimo, a manchete aprovada, o motivo da decisão ter sido tomada. Mantenha o material de origem completo e deixe o índice e os links fazerem a navegação.
Mantenha as decisões separadas das instruções
Uma decisão (“usamos OKF para memórias de agentes, porque arquivos permanecem portáteis”) é um tipo diferente de página de um procedimento. Dê a cada um seu próprio conceito, vincule-os, e um agente encontrará o porquê, assim como o como.
Decida quem mantém o cérebro
O template permite que uma equipe escolha entre duas formas de trabalhar. Em um cérebro peer-to-peer, qualquer agente com acesso pode adicionar e editar conceitos. Em um cérebro centralizado, um agente mantenedor nomeado curaria as páginas. Ponto a ponto é mais fácil de começar. Um único mantenedor ajuda quando muitos agentes escrevem para o mesmo cérebro.
Confirme o que importa
Conceitos escritos pelo agente começam como “não verificados”. Peça para uma pessoa confirmar as páginas das quais outros trabalhos dependem, como as cores da marca ou regras de preço, e use o Histórico para revisar o que mudou desde sua última visualização.
Dê a cada agente a mesma memória de trabalho
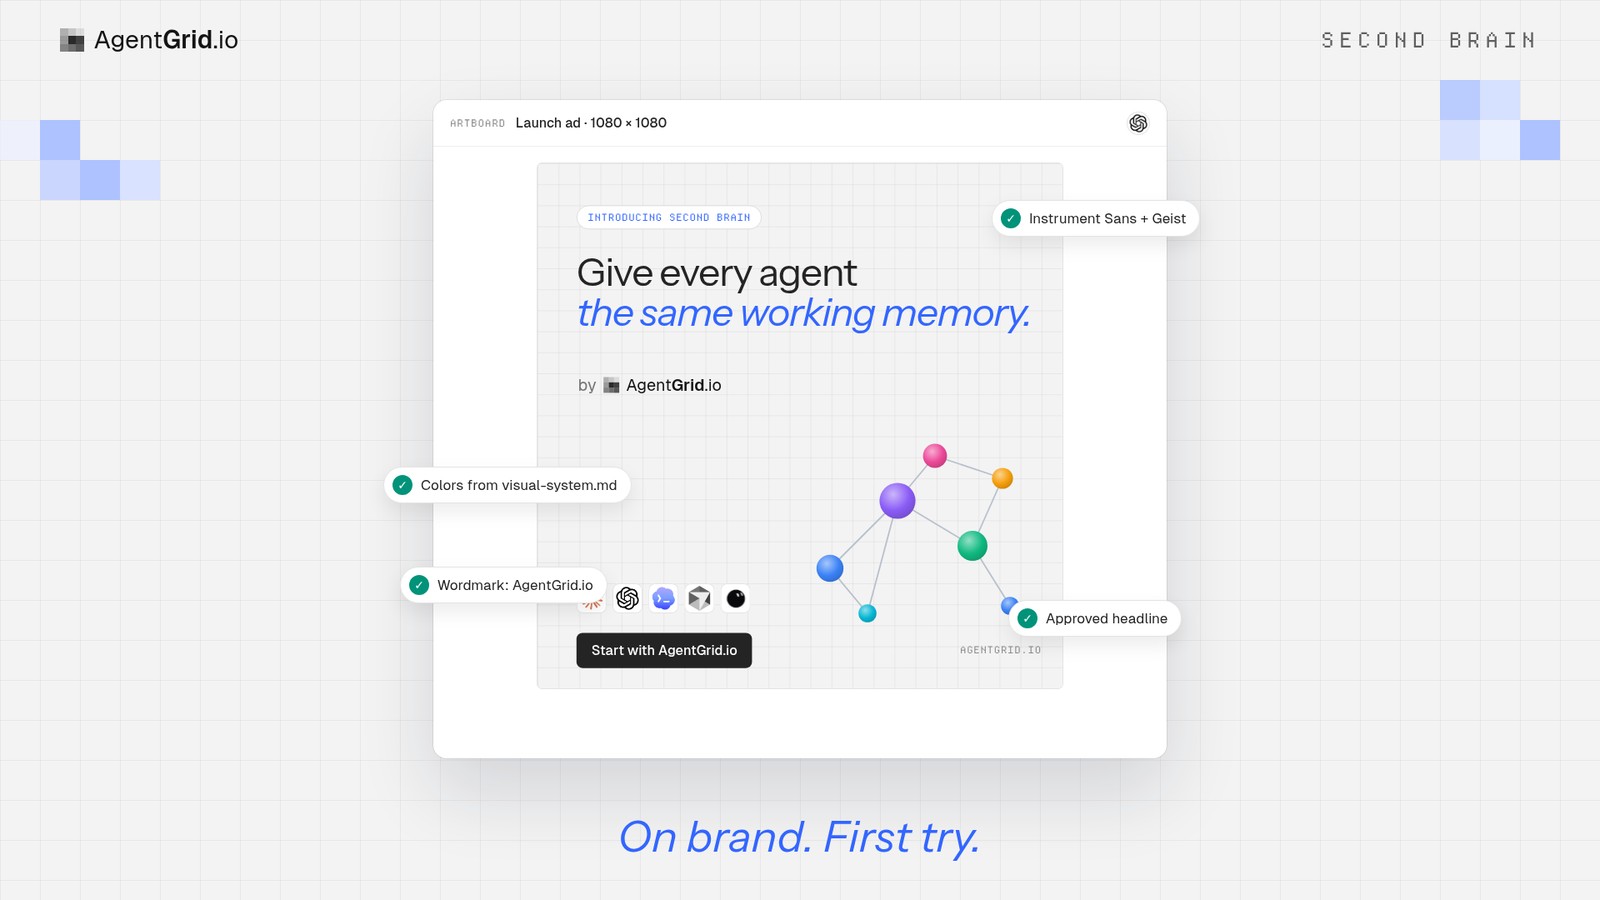
Não acho que o futuro seja um agente que faz tudo. É uma equipe de pessoas e agentes, cada um bom em uma etapa diferente do trabalho. Isso só funciona se eles compartilharem o que sabem. Um Second Brain dá a eles um único ponto de partida atual: arquivos simples, qualquer agente e você no comando.
Comece sua Second Brain no AgentGrid.io → Então leia o Guia da Base de Conhecimento para os detalhes, ou veja Como a Memória de Trabalho Compartilhada funciona entre agentes.
Perguntas sobre Second Brain
O que é um second brain para agentes de IA?
É uma base de conhecimento mantida que os agentes leem antes de trabalharem e escrevem de volta conforme aprendem. Em vez de rebriefar cada chat, você armazena a marca, as decisões e os procedimentos uma vez, e cada agente começa no mesmo contexto.
Second Brain é a mesma coisa que uma Base de Conhecimento sobre AgentGrid.io?
Sim. No app e na documentação, ele é chamado de Base de Conhecimento. É criado a partir do template embutido do AgentGrid.ioe abre com um prompt “Configure seu second brain”.
Claude, ChatGPT e Codex podem usar o mesmo second brain?
Sim. Agentes conectados podem abrir o mesmo cérebro dentro do acesso que você lhes concede. Cada um age sob seu próprio nome, e o Histórico mostra qual agente mudou o quê.
Minha Second Brain é pública?
Não. Criar um cérebro não o publica. O acesso ao espaço de trabalho controla quem pode abri-lo ou alterá-lo, e um link por si só não concede nada.
Posso restaurar uma página que um agente alterou?
Sim. Toda alteração é um commit versionado no Histórico, e você pode restaurar uma versão anterior.
Em que formato os arquivos estão? Posso exportá-los?
O cérebro é Markdown simples, com cabeçalhos YAML no Open Knowledge Format (OKF) v0.2, armazenados no Git. Você pode exportá-lo a qualquer momento e lê-lo sem AgentGrid.io.
Preciso de uma chave API para conectar um agente?
Não. Claude e ChatGPT se conectam por meio dos diretórios de conectores, e os agentes de codificação se conectam com um único comando CLI. Todos eles fazem login pelo seu navegador.
O AgentGrid.io é grátis?
Sim, existe um plano gratuito que cobre hospedagem, equipes, histórico de versões, até 100 artefatos e assentos ilimitados para agentes. Planos pagos adicionam mais capacidade e controles.