 Figma
 Adobe XD
 Sketch
 Discord
 Twitter
 GitHub


 ブログ


Second Brain:使用するすべてのAIエージェントにつき1つの共有メモリ3 min read
Reading Time: 3 minutesClaude はあなたのブランドを知っています。 ChatGPT その通知を受け取っていません。 Codex は先月のコピーをもとにしています。新しいチャットを開くたびに、エージェントを変えるたびにブリーフを貼り直すだけで、どのエージェントも少しずつ違う真実のバージョンを手に入れることになります。複数のAIエージェントと仕事をしているなら、おそらくあなたは彼らの間のコピー&ペーストのレイヤーになってしまっているでしょう。
それが私たちが作り上げた問題です Second Brainfor 。Second Brain(ナレッジベース)はAgentGrid.io上の共有second brainです。これは、チームがグラフとして閲覧し、接続されたエージェントが読み書きを行う、リンクされたMarkdownファイルのバージョン管理された集合です。一度だけブリーフィングします。Claude、ChatGPT、Codex、Cursor、そして接続する他のエージェントも同じメモリから始まり、すべての変更は誰が作成したかを示し、誰がそれに触れてもよいかをあなたが決めます。
仕組みを簡単に説明します。脳を作り、最もよく知っているエージェントにセットアッププロンプトを貼り付け、そのエージェントが知っているものを完全なドキュメントとして保存させ、動作が始まる前に他のエージェントを脳に向けさせます。最初の脳を AgentGrid.io で起動し、すべてのエージェントに同じ作業記憶を与えます。
AgentGrid.ioSecond Brainとは何ですか?
Second Brainは AgentGrid.io 上の知識アーティファクトです。その裏側には、コンセプトと呼ばれるMarkdownノートの小さなGitリポジトリがあります。各コンセプトには短いヘッダー(タイプ、タイトル、説明、タグ、ステータス、誰が生成したか、ソースなど)と通常のMarkdown本文があります。コンセプト同士がつながり、それらのリンクがアプリ内で探索できるグラフの線になります。
これは二種類の読者を同時に対象に作られています。人々はレンダリングされたページ、情報源、そして「引用者リスト」を含むブラウズ可能なグラフを手に入れます。エージェントはすべてのフォルダにインデックス付きのシンプルなファイルを受け取るので、タスクに必要なものだけを読み込むことができ、脳全体を飲み込むことはありません。
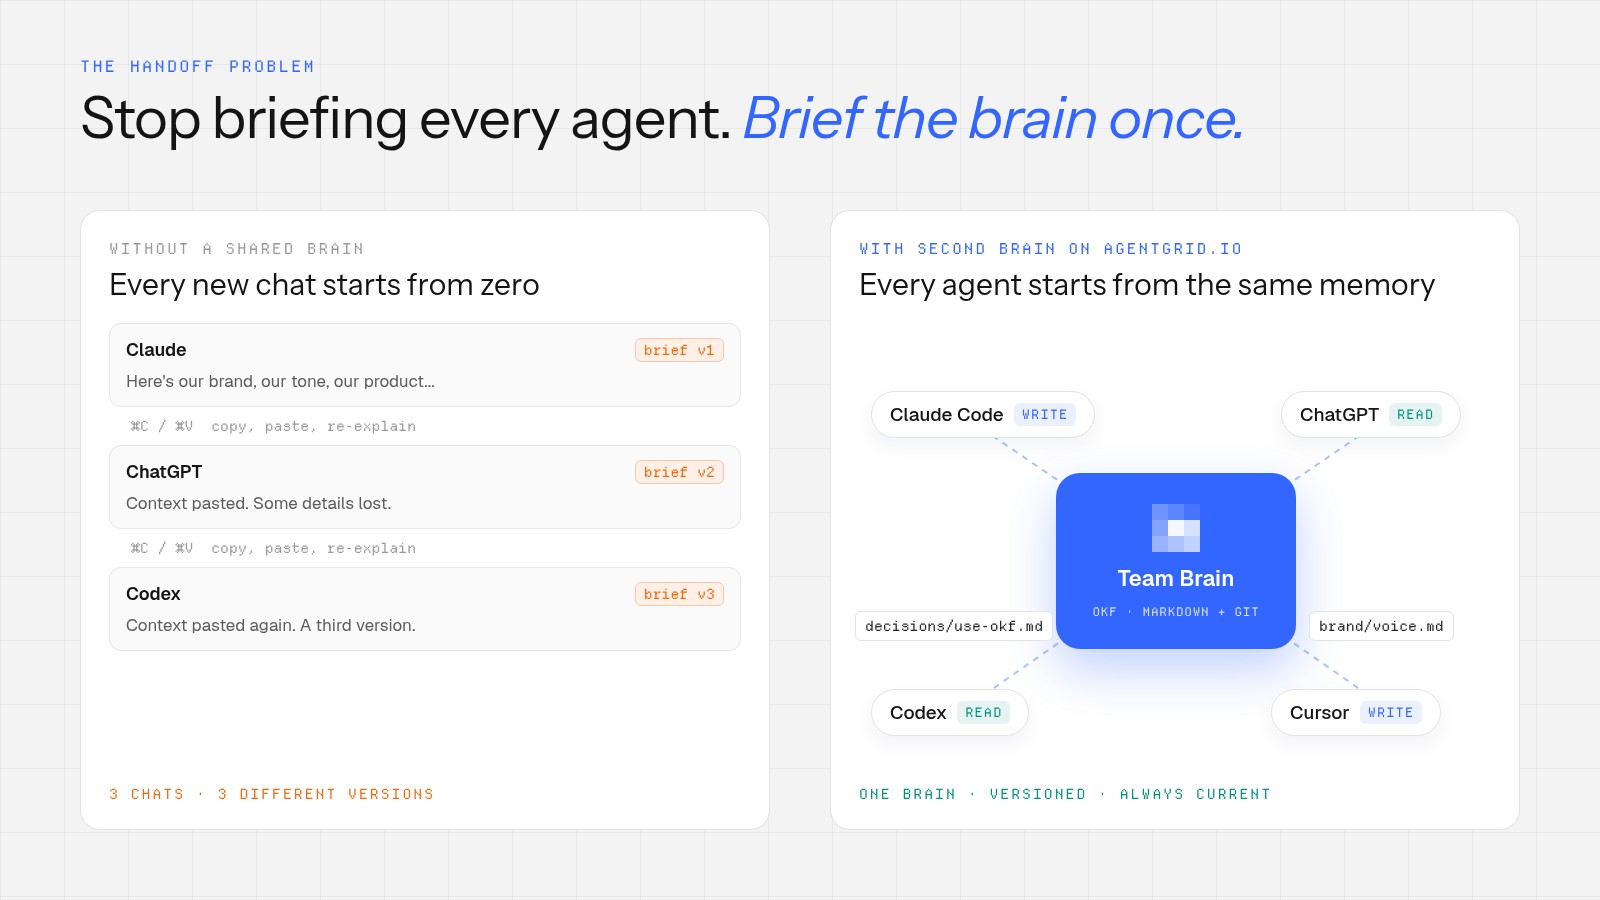
考え方はシンプルです:知識は一つのチャットの中に収まるのではなく、仕事そのものと共にあります。 AgentGrid.io サイトではこう表現しています:「あなたのエージェントは素晴らしい。ハンドオフが壊れています。」 Second Brain とは、そのハンドオフを直す方法です。
共有 second brain が、毎回チャットを繰り返すより優れている理由
「second brain」という考え方は、もともとは個人的な習慣として始まりました。つまり、知っていることをメモに残し、後で見つけて再利用できるようにする、ということです。AIがそれをより大きなものへと変えました。 Andrej KarpathyのLLM Wikiパターンは、エージェントが生のソースと質問の間に Markdown ページを連結したウィキを管理できることを示しました。つまり、知識は一度まとめられて最新の状態に保たれるのです。現在では多くの人が、そのバージョンを Obsidian やローカルフォルダで運用しています。
問題は、作業が共有されたときに始まります。内蔵のチャットメモリは1つのアカウントと1つの製品に属しています。ローカルのボルトは1台のノートパソコンに存在します。プロンプトのフォルダが各ツールにコピーされ、漂流します。2人目や3人目のエージェントが参加したり、チームメイトがプロジェクトを引き継いだりしても、そのコンテキストは後方に残ります。私はこの緊張について書いたことがあります 会社 second brain:ウィキからスキルまで、すべては文脈次第です. Second Brain 、毎日複数のエージェントと連携するチームへの私たちの答えです。
共有 second brain は三つのことを変えます:
- 真実の源は一つ。 ブランド、決定、承認された文言は、すべての関係者エージェントが最初に読む一つの場所に集まっています。
- 目に見える歴史。 すべての変更は名前と時間付きのコミットなので、どのエージェントや担当者がページを変更したかを確認し、以前のバージョンを復元できます。
- 明確な境界線。 ワークスペースへのアクセス権によって、誰が、どのエージェントが読んだり投稿したりできるかが決まります。リンク自体は何も得られず、脳を作ることで公開されることもありません。
5ステップで Second Brain を設定する方法
- 脳を作りましょう。 “+” → “New Brain” をクリックするか、エージェントに新しいナレッジブレインの作成を依頼してください。
- セットアッププロンプトをエージェントに渡してください。 ダイアログからプロンプトをコピーし、トピックについて最も詳しいエージェント(例:ブランドフォルダを開いた Claude コード)に貼り付けます。
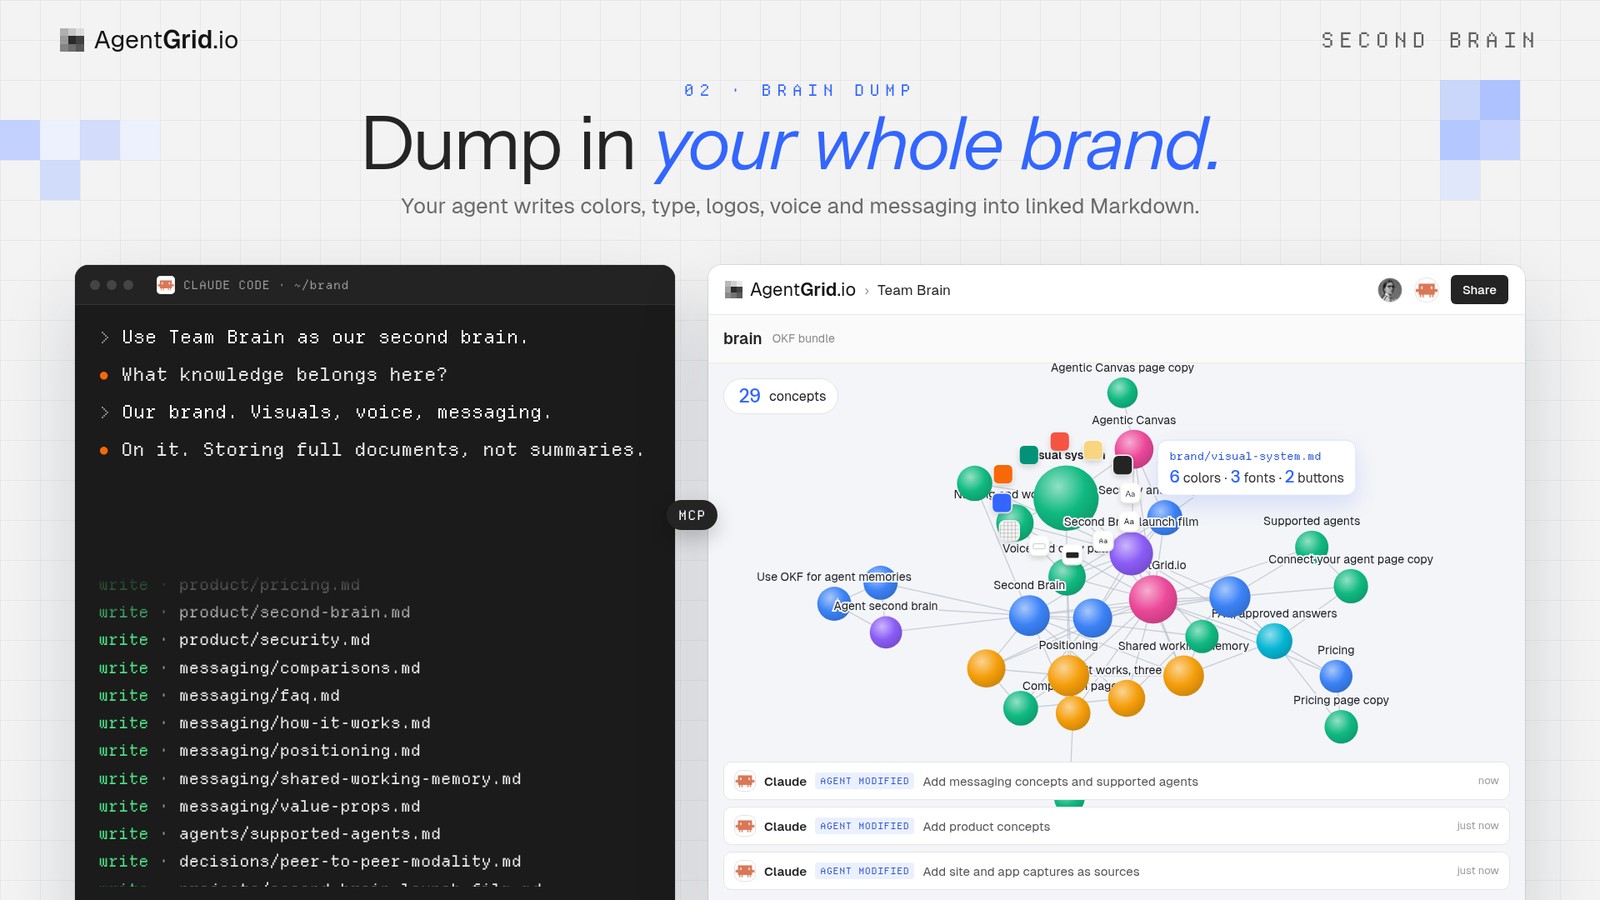
- 知っていることを注ぎ込ませておけ。 エージェントは脳に何が属するのかを問い、それを色、フォント、ロゴ、声、メッセージ、意思決定、そしてそれらの背後にある情報源といった関連概念として書き記します。
- 閲覧して確認してください。 頭を開いてグラフを探り、描かれた概念や Markdownを読み、重要なページを確認してください。概念は誰かが確認するまで「未検証」のままです。
- それを活かせ。 接続されたエージェントに、起動前に頭を使うよう頼んでください。それはインデックスを読み、必要なリンクをたどり、貼り付けた要約ではなく、あなたの本当のブランドや意思決定に基づいて動きます。
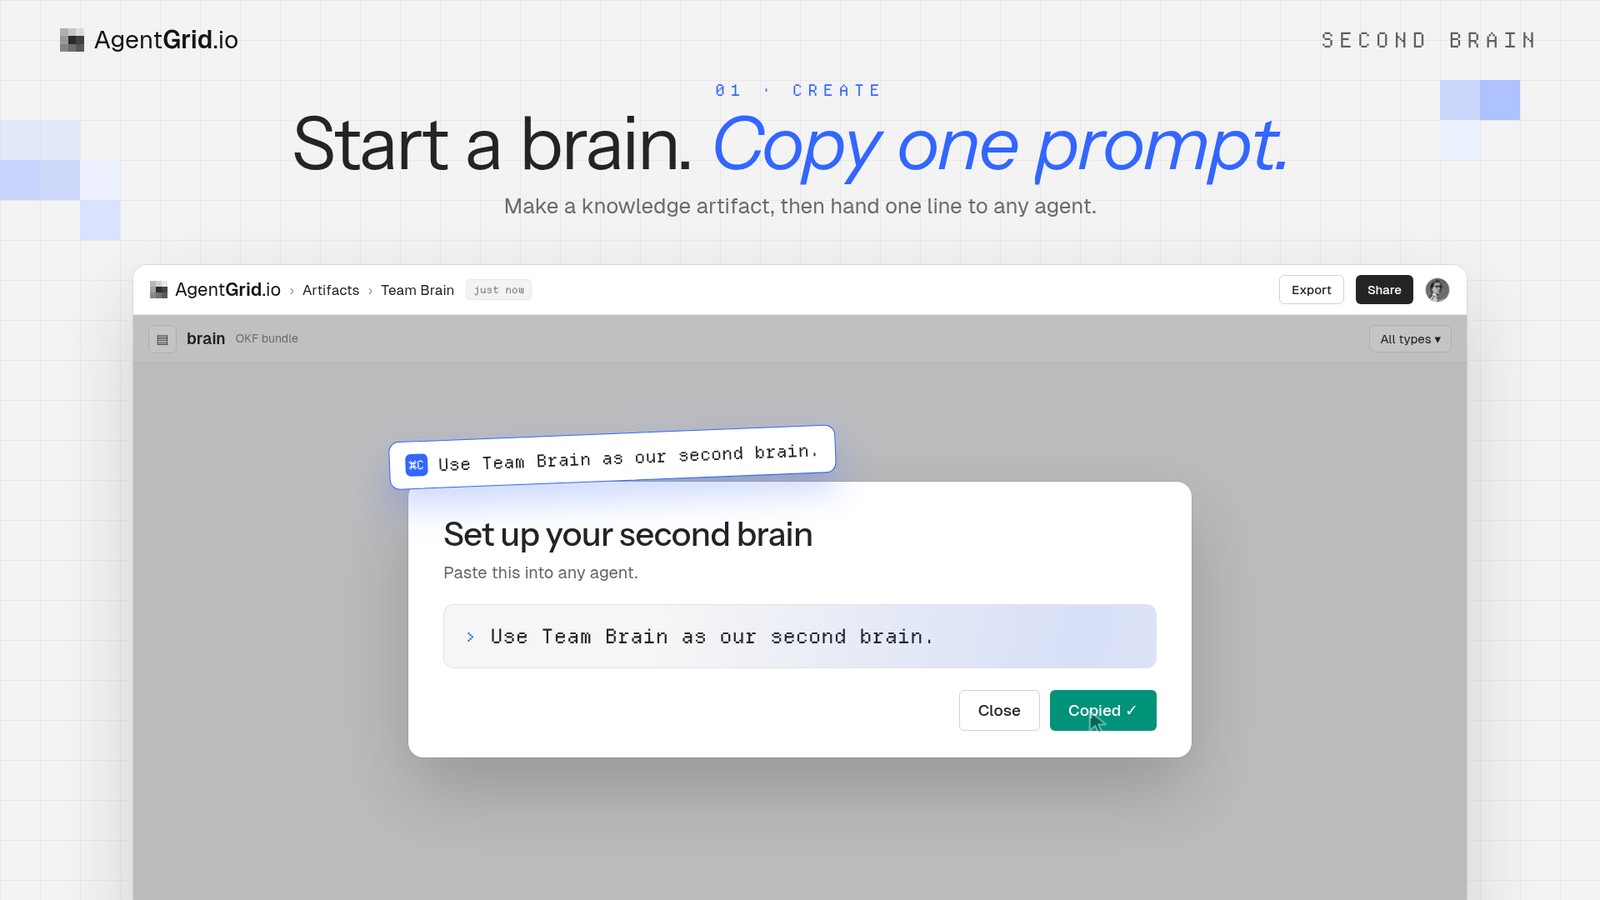
セットアップのプロンプトは意図的に短くなっています。アプリ内にはこう書かれています:
Use <artifact link> for a second brain.
If it is not clear what knowledge belongs here, ask for clarification. Do not guess.
Once that's clear, dump all target knowledge documents as they are, but to use the artifact format to store them.
This is intended for sharing your knowledge with other agents, so it's important that you don't summarize, sanitize or condense the data, but to keep it full and complete so that another agent can utilize this.
Do not share credentials or secret keys to this artifact.
そのプロンプトの2行がほとんどの役割を果たします。「明確さを求めてください。推測しないでください」は、エージェントが頭の中に思い込みを詰め込むのを止めます。「要約したり、消毒したり、要約したりしない」が重要なのは、次のエージェントがブランドガイドや意思決定記録の完全なものを必要としているからで、1段落のまとめではありません。
脳を開いたときに見えるもの
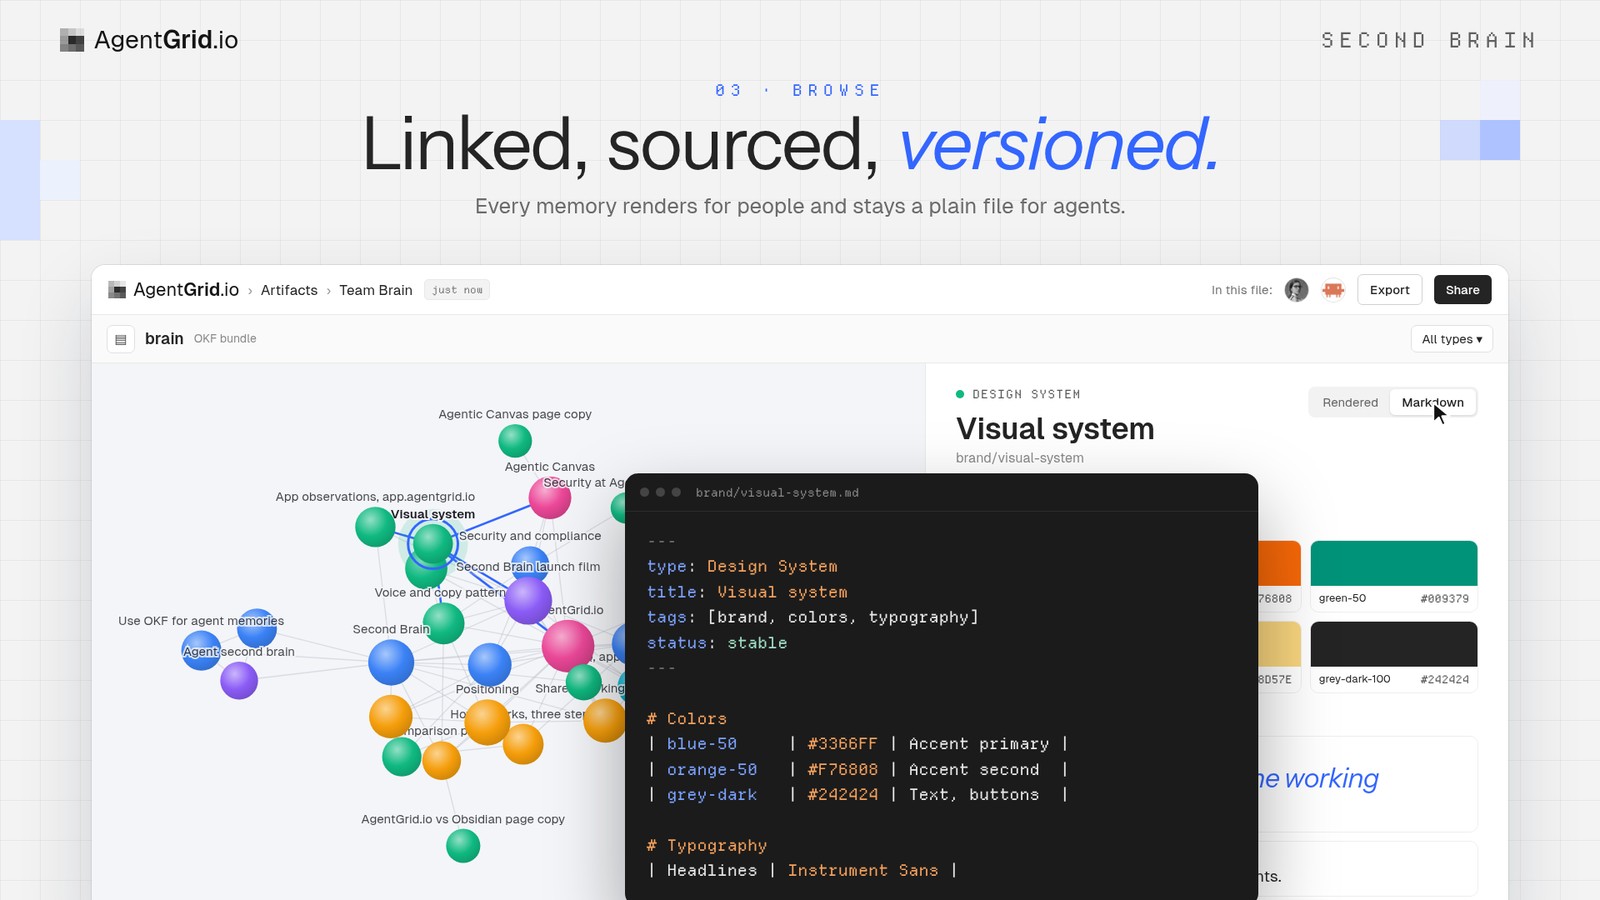
脳はグラフのように開きます。各概念はタイプごとに色分けされたノードであり、概念間のリンクは線で描かれます。ノードを選択すると、詳細パネルにその説明、タグ、生成者、出典、引用する概念が表示されます。 Markdown ビューに切り替えると、エージェントが読んだのと同じ普通のファイルが表示されます。
Second Brainの中には何が入っているのですか?
Second Brain は Open Knowledge Format (OKF)v0.2に従い、人やエージェントが書いた知識のためのオープンフォーマットです。ファイルはデータベースやモデルプロバイダー、特別なツールがなくても読み取れます。 Markdown ファイルを開ければ脳を読み、いつでもエクスポートできます。
| パート | それが何をするのか |
|---|---|
| コンセプト | 短いヘッダー(タイプ、タイトル、説明、タグ、ステータス、誰が作成したか、出典)と本文がある Markdown ファイル。 |
| リンク | 概念間の通常の Markdown リンク。リンクはグラフの線や「引用者」リストとなります。 |
| 索引 | すべてのフォルダに index.md がある。エージェントはそれを最初に読み、タスクに必要なものだけを読み込む。 |
| ログ | 何が何で、なぜ変わったのかについての古びた log.md。 |
| 現状 | 「安定」「ドラフト」「非推奨」、さらに「未検証」が確認されるまで続きます。 |
| 歴史 | すべての変更はバージョン制御されたコミットであり、それを行った人物またはエージェントに帰属され、以前のバージョンは復元可能です。 |
その背後にあるテンプレートはオープンソースです。読み取れるか、同じ形式でローカルで実行できます。 GitHub上のsecond-brain-templateリポジトリ.
最初の脳に何を入れるか
何度も何度も必要としている知識から始め、それが漂うと痛いものです。これが良い最初の頭脳です:
| 脳 | 何が入るのか | エージェントがそれを必要とする理由 |
|---|---|---|
| ブランドとメッセージング | ネーミング、声、色、タイプ、ロゴ、承認ライン | 広告、投稿、ページは、初めてブランドに合った形で掲載されます |
| 設計システム | トークン、コンポーネント、パターン | プロトタイプは汎用的な見た目ではなく、本物の外観を使います |
| 工学的標準 | ルール、アーキテクチャの決定、ランブックのレビュー | コーディングエージェントも同じ慣行に従います |
| プロジェクトメモリ | ブリーフ、リサーチ、決定、成果を一回のローンチにまとめた | 次のエージェントは、前のエージェントが止まったところからそのまま続けた |
認証情報、秘密鍵、個人データはすべての脳の中から遠ざけてください。セットアッププロンプトにはエージェントにそれらを保存しないよう指示されており、これは人にとっても良いルールです。
どのAIエージェントが Second Brainを使えますか?
接続したどのエージェントでも、 AgentGrid.io 与えたアクセスの範囲内で脳と連携できます。サイトには Claude、 ChatGPT、 Codex、 Claude Code、 Cursor、Hermes、OpenClaw、Grok Bot、Instinct、Museが掲載されています。それらは異なる方法で接続しており、APIキーは必要ありません。
| エージェント | つながり方 |
|---|---|
| Claude | ClaudeのディレクトリからAgentGrid.ioコネクタをインストールし、サインインしてください |
| ChatGPT | ChatGPTのコネクタディレクトリからコネクタをインストールし、サインインします |
| コーディングおよび自律型エージェント(Claude Code、 Codex、 Cursor、OpenClaw、Hermes、Grok Bot、Instinct、Muse) | コマンド1つ: npx @animaapp/cli@latest login次にブラウザーでサインインを承認します |
オプションの完全なリストは エージェントをつなぐ ページ。使うエージェントの数だけ接続できます。それぞれが独立した名前で動作するため、履歴にはどのエージェントが何を変更したかが正確に示されます。
Second Brainが安全に共有できる方法について
すべてのエージェントが読み取れるメモリは、その中に何が入っていて、誰がそれを変更できるかを信頼して初めて有用です。 Second Brain は、 AgentGrid.ioの他のすべてと同じルールに基づいて構築されています:
- エージェントはエージェントとして認証します。 コネクタはエージェントにパスワードやその他のファイルを提供しません。
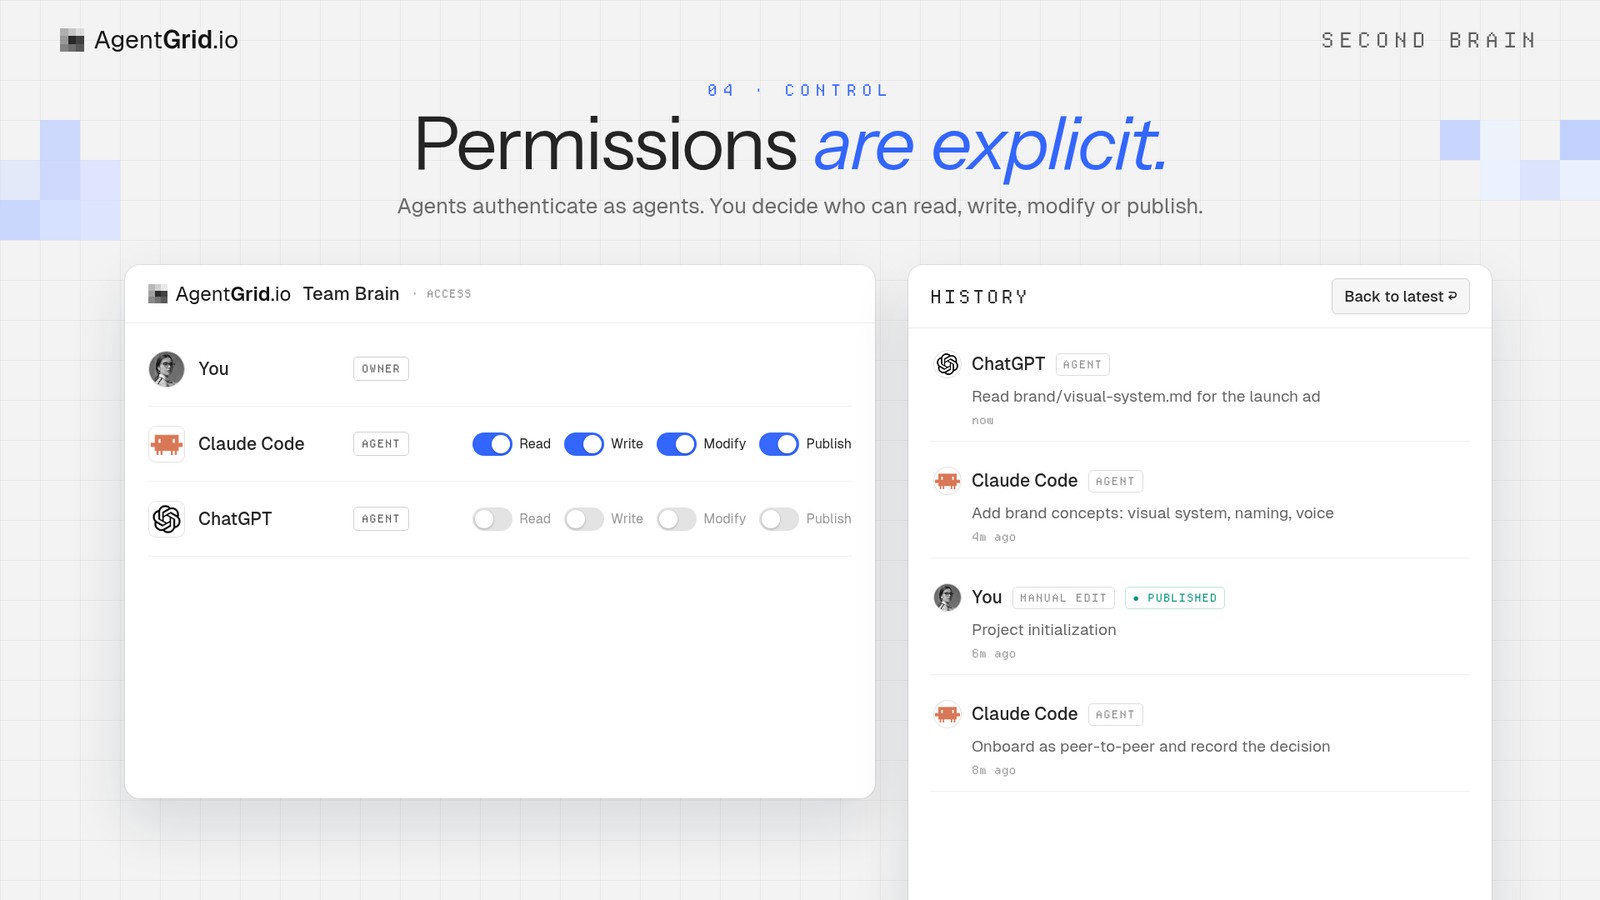
- 権限は明示的です。 ワークスペースアクセスによって、どの人やエージェントが読み書き、変更、公開できるかが決まります。貼り付けたリンク自体は何も付与しません。
- すべての編集には帰属が記載されています。 エージェントの変更は、チームメイトと同じようにエージェントバッジとタイムスタンプとともに履歴に表示されます。
- どのバージョンでも復元可能です。 エージェントが間違ったことを書いたら、脳を巻き戻す。
- 一部のアクションは人間だけのままです。 削除、チーム外での共有、請求はエージェントの行動ではありません。
- 共有は公開ではありません。 新しい脳は、誰かが明示的に発表するまで、あなたの作業スペースの中にとどまっています。
Second Brain メモアプリ、チャットメモリ、 RAG ツールと比較してください
この問題の各部分には良いツールがあります。違いは、そのメモリが誰のためのもので、どこに保管されているかです。
| アプローチ | 素晴らしい用途 | どこで止まるのか |
|---|---|---|
| パーソナルノートアプリ(Obsidian) | グラフビューやプラグインを使って、自分の知識をローカル Markdownで記録・リンクする方法 | 一人の人間を中心に構築;他のエージェントやチームメイトと共有するには追加のセットアップが必要になります |
| 内蔵チャットメモリ | 1つのアシスタントの中で自分の好みを覚えておく | 1つの商品とアカウントに紐づいています。他のエージェントはそれを読み取ることができません。 |
| ベクターまたは RAG ナレッジベース | 意味による大規模なドキュメントセットの検索 | 人々が読んで修正できる、キュレーションされたリンクされたページの集合ではなく、チャンクを取得します |
| Second Brain AgentGrid.io | 共有されたバージョン制御メモリが1つあり、ユーザーが閲覧し、接続されたエージェントが読み書きします | キュレーションが必要だ:脳はあなたやエージェントがどれだけ入れるかにかかっています |
それらは連携して動作します。すでにObsidianにボルトを置いているなら、AgentGrid.ioObsidianとの公平な比較 要するに「個人的な知識は入っている。共有実行はアウト。」
エージェントが実際に使う脳のためのコツ
捨てる前に必ず確認してください
最高の頭脳は、明確な視野から始めます。エージェントに何かを書く前に、ここに何がふさわしいのかを尋ね、一文で答えてください。「私たちのブランド。ビジュアル、声、メッセージ。」すべてについての脳は、どんなエージェントも操ることのできない脳です。
要約ではなく、文書全体を保存します
要約は整頓されているように感じますが、作品を正しく表現するための細部――正確な六角数値、承認された見出し、決定が下された理由――を省いてしまうのです。ソース資料は完全なものに保ち、索引やリンクにナビゲーションを任せましょう。
意思決定は指示とは分けておきましょう
意思決定(「エージェントの記憶には OKF を使います。ファイルは持ち運びやすいためです」)は、手続きとは異なる種類のページです。それぞれに独自のコンセプトを与え、リンクさせれば、エージェントは「なぜ」と「どのように」を解き明かすことができます。
誰が脳を維持するか決める
テンプレートを使えば、チームは2つの作業方法から選択できます。ピア・ツー・ピア・ブレインでは、アクセス権を持つエージェントなら誰でも概念を追加・編集できます。中央集約型のブレインでは、名前のあるメンテナーエージェントがページをキュレーションします。ピアツーピアは始めるのが簡単です。複数のエージェントが同じブレインに書き込みを行う場合、単一のメンテナが役立ちます。
重要なことを確認する
エージェントが書いたコンセプトは「未検証」として始まります。ブランドカラーや価格ルールなど、他の仕事がどのページに依存しているかを担当者に確認してもらい、前回のルック以降に何が変わったかを履歴で確認してもらいましょう。
すべてのエージェントに同じ作業メモリを与えてください
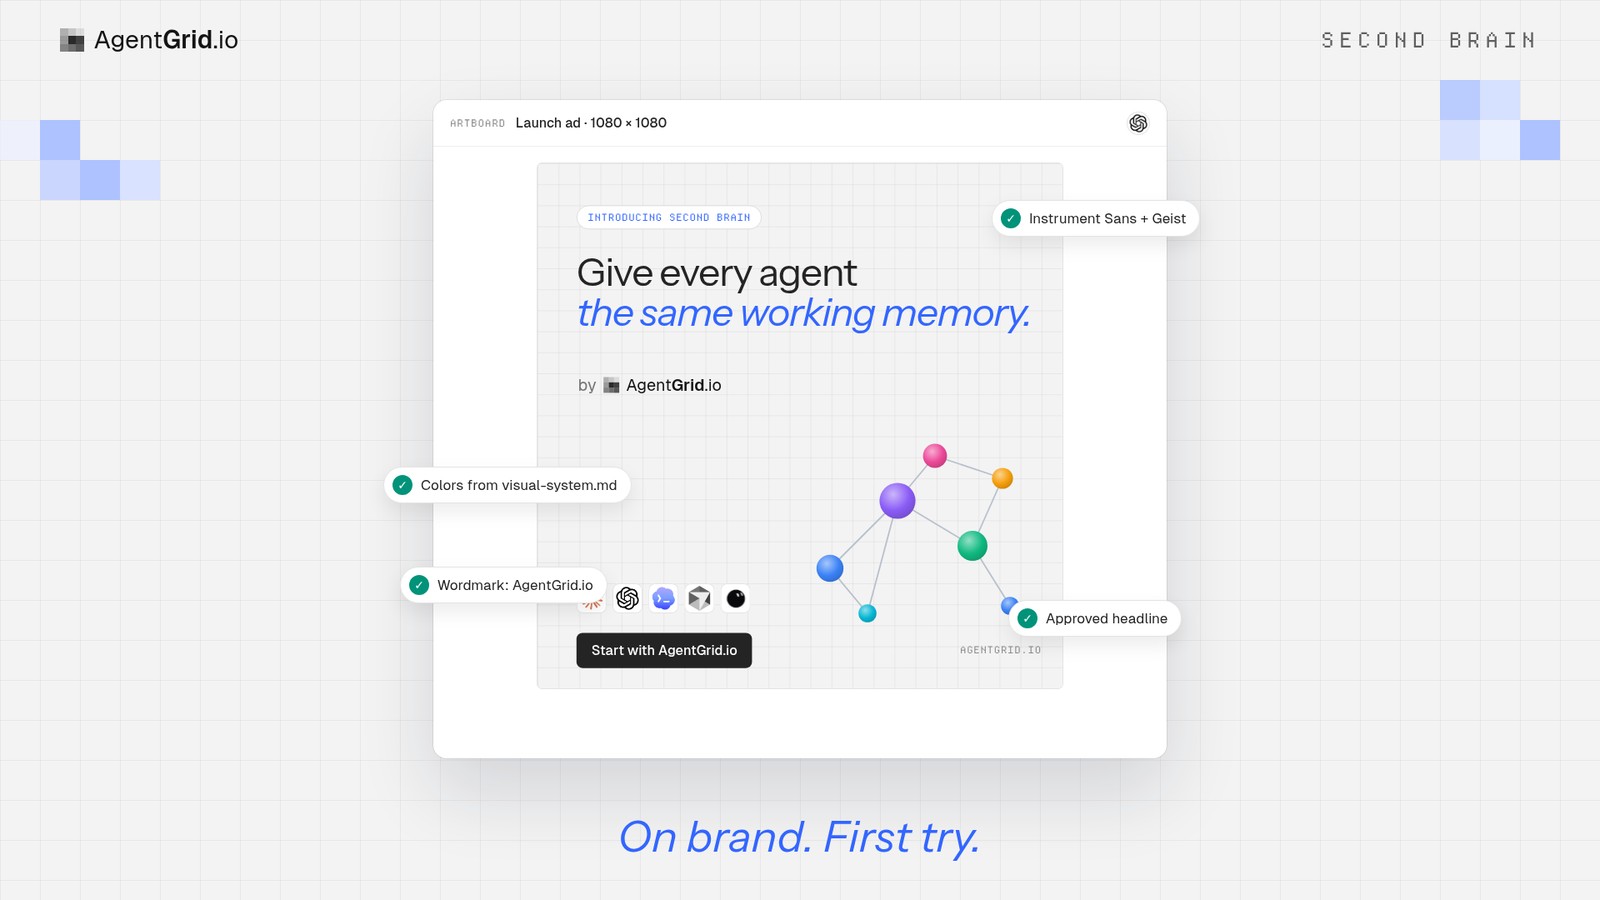
未来は一人のエージェントがすべてをやるものではないと思います。それは人とエージェントのチームであり、それぞれが仕事の異なる段階で優秀な人材です。それは彼らが知っていることを共有しない限り機能しません。 Second Brain は彼らに現在の出発点を一つだけ与えてくれます:普通のファイル、どんなエージェント、そしてあなたが責任者です。
Second Brainを始めましょうAgentGrid.io → それから、 ナレッジベースガイド 詳細については、または エージェント間で共有作業記憶がどのように機能するか.
Second Brainに関する質問
AIエージェントのための second brain とは何ですか?
これは、エージェントが作業前に読み、学びながら書き返す、維持されたナレッジベースです。各チャットを繰り返すのではなく、ブランド、決定、手順を一度だけ保存し、すべてのエージェントが同じコンテキストからスタートします。
Second BrainAgentGrid.ioのナレッジベースと同じものなのでしょうか?
はい。アプリやドキュメントではナレッジベースと呼ばれています。 AgentGrid.ioの組み込みテンプレートから作成され、「 second brain設定」というプロンプトが表示されます。
Claude、ChatGPT、Codexは同じsecond brainを使えますか?
はい。接続されたエージェントは、あなたが与えたアクセス内で同じ脳を開くことができます。それぞれが自分の名前で行動し、履歴にはどのエージェントが何を変えたかがわかります。
私の Second Brain は公開されていますか?
いいえ。脳を作成しても公開されるわけではありません。ワークスペースのアクセス権が誰を開いたり変更したりできるかを制御し、リンク自体は何も許しません。
エージェントが変更したページを復元できますか?
はい。すべての変更はHistoryでのバージョン管理されたコミットであり、以前のバージョンを復元できます。
ファイルはどんな形式ですか?エクスポートできますか?
脳はOpen Knowledge Format(OKF)v0.2のYAMLヘッダーでGitに保存されたシンプルなMarkdownです。いつでもエクスポートでき、AgentGrid.io せずに読み取ることができます。
エージェントを接続するのにAPIキーは必要ですか?
いいえ。 Claude と ChatGPT はそれぞれのコネクタディレクトリを通じて接続し、コーディングエージェントは1つのCLIコマンドで接続します。すべてブラウザ経由でサインインします。
AgentGrid.io無料ですか?
はい、ホスティング、チーム、バージョン履歴、最大100件のアーティファクト、無制限のエージェント席をカバーする無料プランがあります。有料プランは容量やコントロールを増やします。