 Figma
 API
 Web to code extension
 Adobe XD
 Discord
 Twitter
 GitHub
 Blog


Second Brain: Eén gedeeld geheugen voor elke AI-agent die je gebruikt14 min read
Reading Time: 10 minutesClaude kent je merk. ChatGPT heb de memo nooit ontvangen. Codex werkt met het exemplaar van vorige maand. Elke keer dat je een nieuwe chat opent of van agent wisselt, plak je de brief opnieuw en elke agent krijgt uiteindelijk een iets andere versie van de waarheid. Als je met meer dan één AI-agent werkt, ben je waarschijnlijk de copy-paste-laag tussen hen geworden.
Dat is het probleem dat we hebben opgebouwd Second Brain voor. Second Brain (Knowledge Base) is een gedeelde second brain op AgentGrid.io: een geversiede set gekoppelde Markdown bestanden die je team als grafiek doorbladert en die je verbonden agenten lezen en schrijven. Je brieft het één keer. Claude, ChatGPT, Codex, Cursor en de andere agenten die je verbindt starten vanuit hetzelfde geheugen, elke wijziging laat zien wie het heeft gemaakt en bepaal jij welke mensen en agenten het mogen aanraken.
Hier is de korte versie van hoe het werkt: maak een brein, plak één setup-prompt in de agent die het meest weet, laat die opslaan wat hij weet als volledige documenten, en richt vervolgens elke andere agent op het brein voordat het begint te werken. Start je eerste brein op AgentGrid.io en geef elke agent hetzelfde werkgeheugen.
Wat is Second Brain op AgentGrid.io?
Een Second Brain is een kennisartefact op AgentGrid.io. Onder de motorkap is het een kleine Git verzameling van Markdown notities, genaamd concepten. Elk concept heeft een korte header (type, titel, beschrijving, tags, status, wie het heeft gegenereerd en de bronnen) en een normale Markdown hoofdtekst. Concepten verbinden elkaar, en die links worden de lijnen in een grafiek die je in de app kunt verkennen.
Het is gebouwd voor twee soorten lezers tegelijk. Mensen krijgen een doorbladerbare grafiek met weergegeven pagina’s, bronnen en een “Geciteerd door”-lijst. Agenten krijgen eenvoudige bestanden met een index in elke map, zodat ze alleen kunnen laden wat een taak nodig heeft in plaats van het hele brein op te slokken.
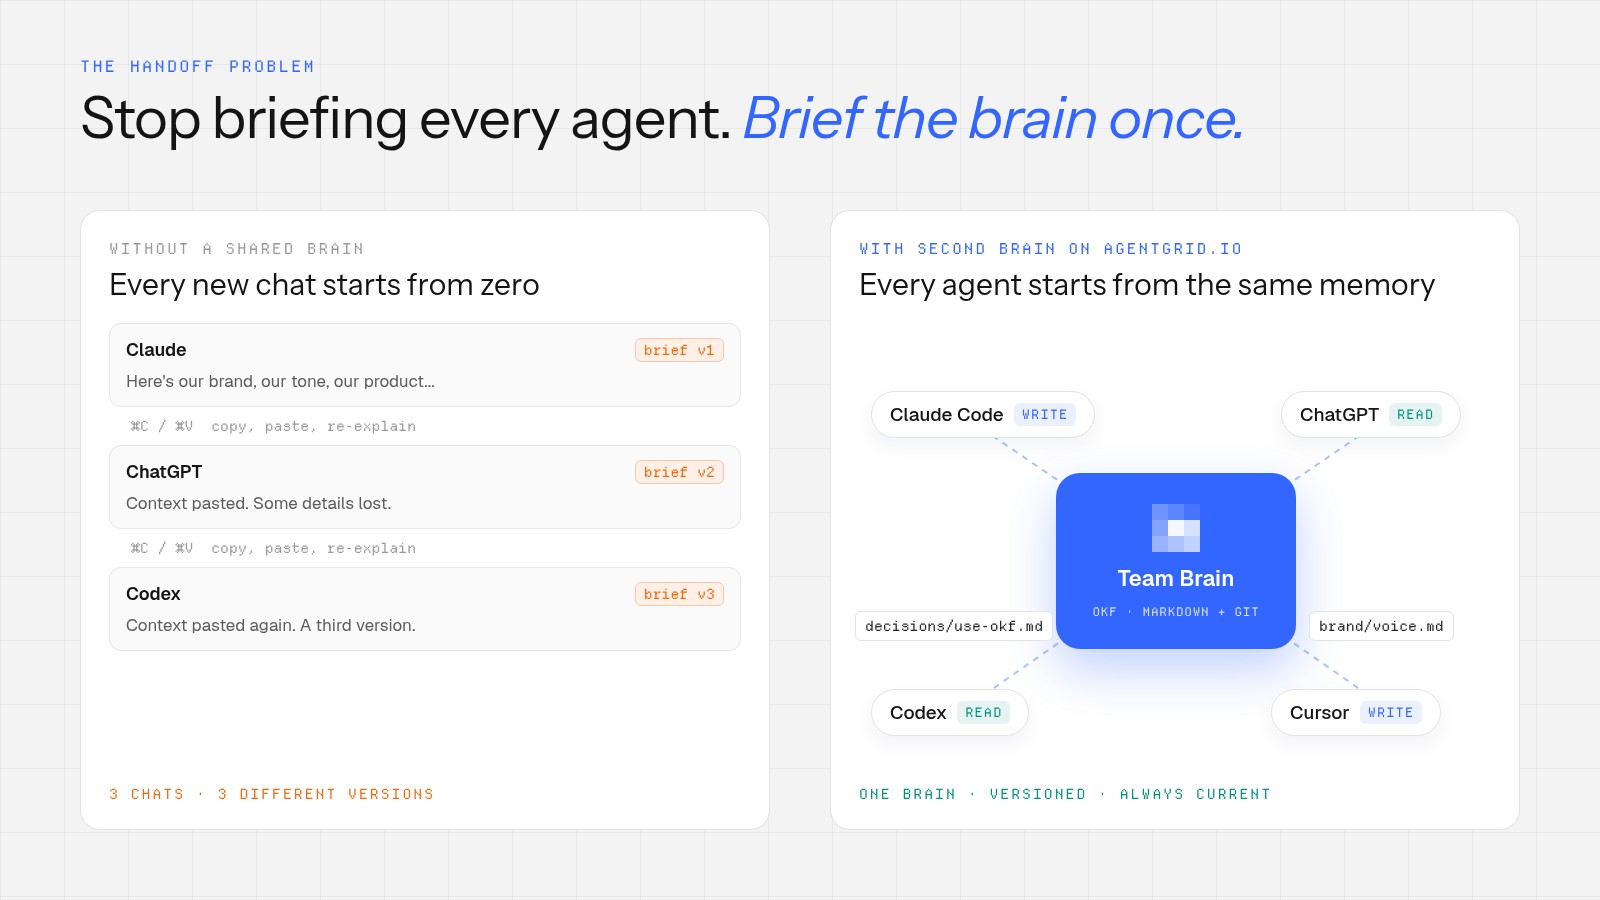
Het idee is simpel: de kennis leeft bij het werk, niet in één chat. Op de AgentGrid.io site formuleren we het zo: “Je agenten zijn briljant. De overdracht is kapot.” Een Second Brain is hoe je de overdracht oplost.
Waarom een gedeelde second brain beter is dan het opnieuw briefen van elke chat
Het “second brain”-idee begon als een persoonlijke gewoonte: vastleggen wat je weet in aantekeningen zodat je het later kunt vinden en hergebruiken. AI maakte er iets groters van. Andrej Karpathy’s LLM Wiki-patroon liet zien hoe een agent een onderling verbonden wiki kan onderhouden van Markdown pagina’s tussen je ruwe bronnen en je vragen, zodat kennis eenmaal wordt samengesteld en actueel gehouden blijft. Veel mensen draaien nu een versie daarvan in Obsidian of een lokale map.
Het probleem begint wanneer het werk wordt gedeeld. Het ingebouwde chatgeheugen behoort toe aan één account en één product. Een lokale kluis staat op één laptop. Een map met prompts wordt in elke tool gekopieerd en drift. Wanneer een tweede of derde agent zich aansluit, of een teamgenoot het project overneemt, blijft de context achter. Ik schreef over deze spanning in Bedrijfs second brain: van wiki tot vaardigheden, het draait allemaal om context. Second Brain is ons antwoord voor teams die dagelijks met meerdere agenten werken.
Een gedeelde second brain verandert drie dingen:
- Eén bron van waarheid. Het merk, de beslissingen en de goedgekeurde formulering zitten op één plek die elke verbonden agent als eerste leest.
- Zichtbare geschiedenis. Elke wijziging is een commit met een naam en een tijdstip, zodat je kunt zien welke agent of persoon een pagina heeft veranderd en een eerdere versie kunt herstellen.
- Duidelijke grenzen. Workspace-toegang bepaalt wie en welke agenten mogen lezen of bijdragen. Een link op zichzelf levert niets op, en het creëren van een brein publiceert het niet.
Hoe je een Second Brain in vijf stappen opzet
- Maak een brein. Klik op “+” → “New Brain”, of vraag je agent om een nieuw kennisbrein te maken.
- Geef de installatieprompt aan je makelaar. Kopieer de prompt uit het dialoogvenster en plak deze in de agent die het meest van het onderwerp op de hoogte is, bijvoorbeeld Claude Code met uw merkmap open.
- Laat het erin gieten wat het kent. De agent vraagt wat er in het brein thuishoort en schrijft het vervolgens als gekoppelde concepten: kleuren, lettertypen, logo’s, stem, boodschappen, beslissingen en de bronnen daarachter.
- Bladeren en controleer. Open je brein, verken de grafiek, lees een concept dat is weergegeven of Markdown, en bevestig de pagina’s die ertoe doen. Concepten blijven als “niet geverifieerd” gemarkeerd totdat iemand ze bevestigt.
- Zet het in werking. Vraag een verbonden agent om het brein te gebruiken voordat het begint. Het leest de index, volgt de benodigde links en werkt vanuit je echte merk en beslissingen in plaats van een geplakte samenvatting.
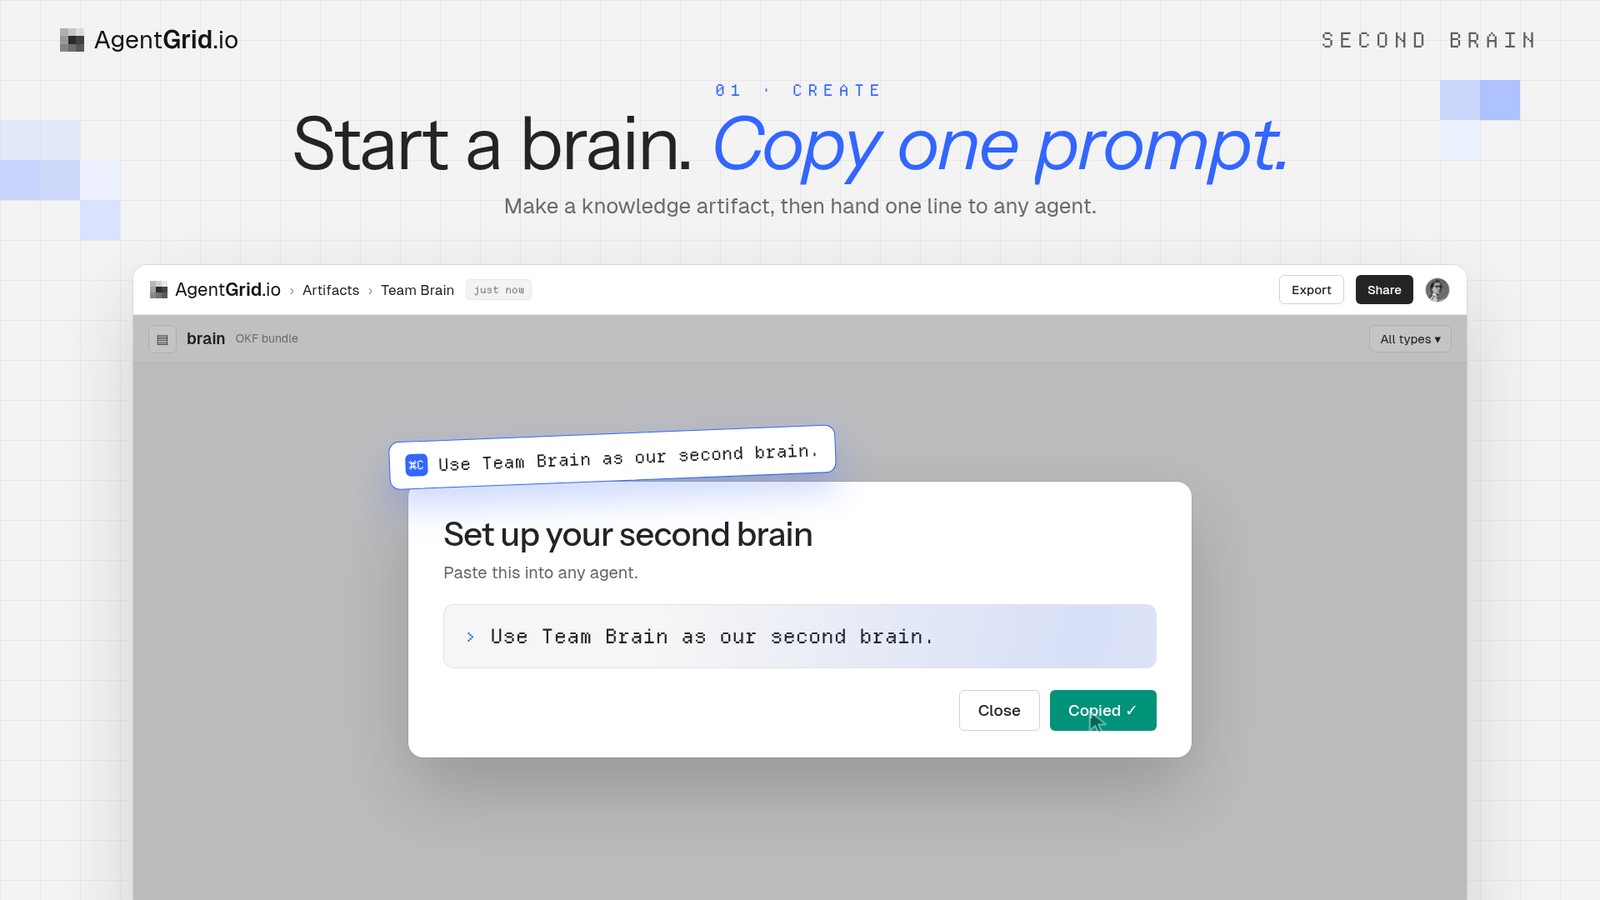
De installatieprompt is expres kort. In de app staat er:
Use <artifact link> for a second brain.
If it is not clear what knowledge belongs here, ask for clarification. Do not guess.
Once that's clear, dump all target knowledge documents as they are, but to use the artifact format to store them.
This is intended for sharing your knowledge with other agents, so it's important that you don't summarize, sanitize or condense the data, but to keep it full and complete so that another agent can utilize this.
Do not share credentials or secret keys to this artifact.
Twee regels in die opdracht doen het grootste deel van het werk. “Vraag om verduidelijking. Raad niet” voorkomt dat de agent het brein vult met aannames. “Niet samenvatten, reinigen of samenvatten” is belangrijk omdat de volgende agent de volledige merkgids of beslissingsdocument nodig heeft, niet een samenvatting van één alinea.
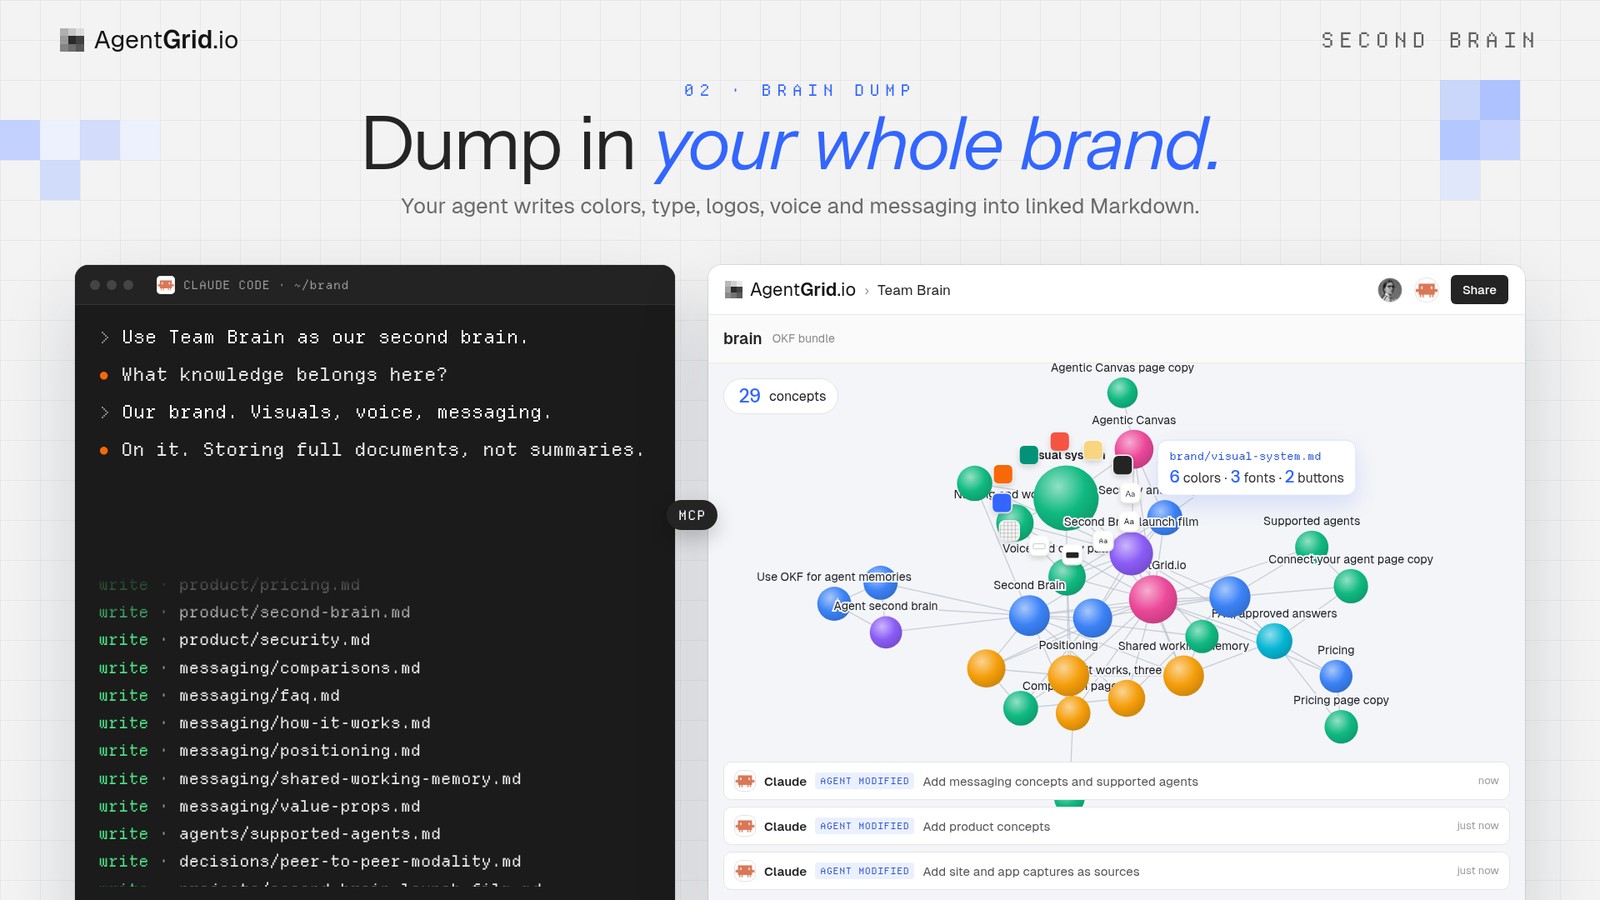
Wat je ziet als je het brein opent
Het brein opent zich als een grafiek. Elk concept is een knooppunt, ingekleurd op zijn type, en de verbanden tussen concepten worden als lijnen getekend. Selecteer een knooppunt en een detailpaneel toont de beschrijving, tags, wie het heeft gegenereerd, de bronnen en de concepten die het citeren. Schakel over naar de Markdown -weergave en je ziet hetzelfde platte bestand dat je agenten lezen.
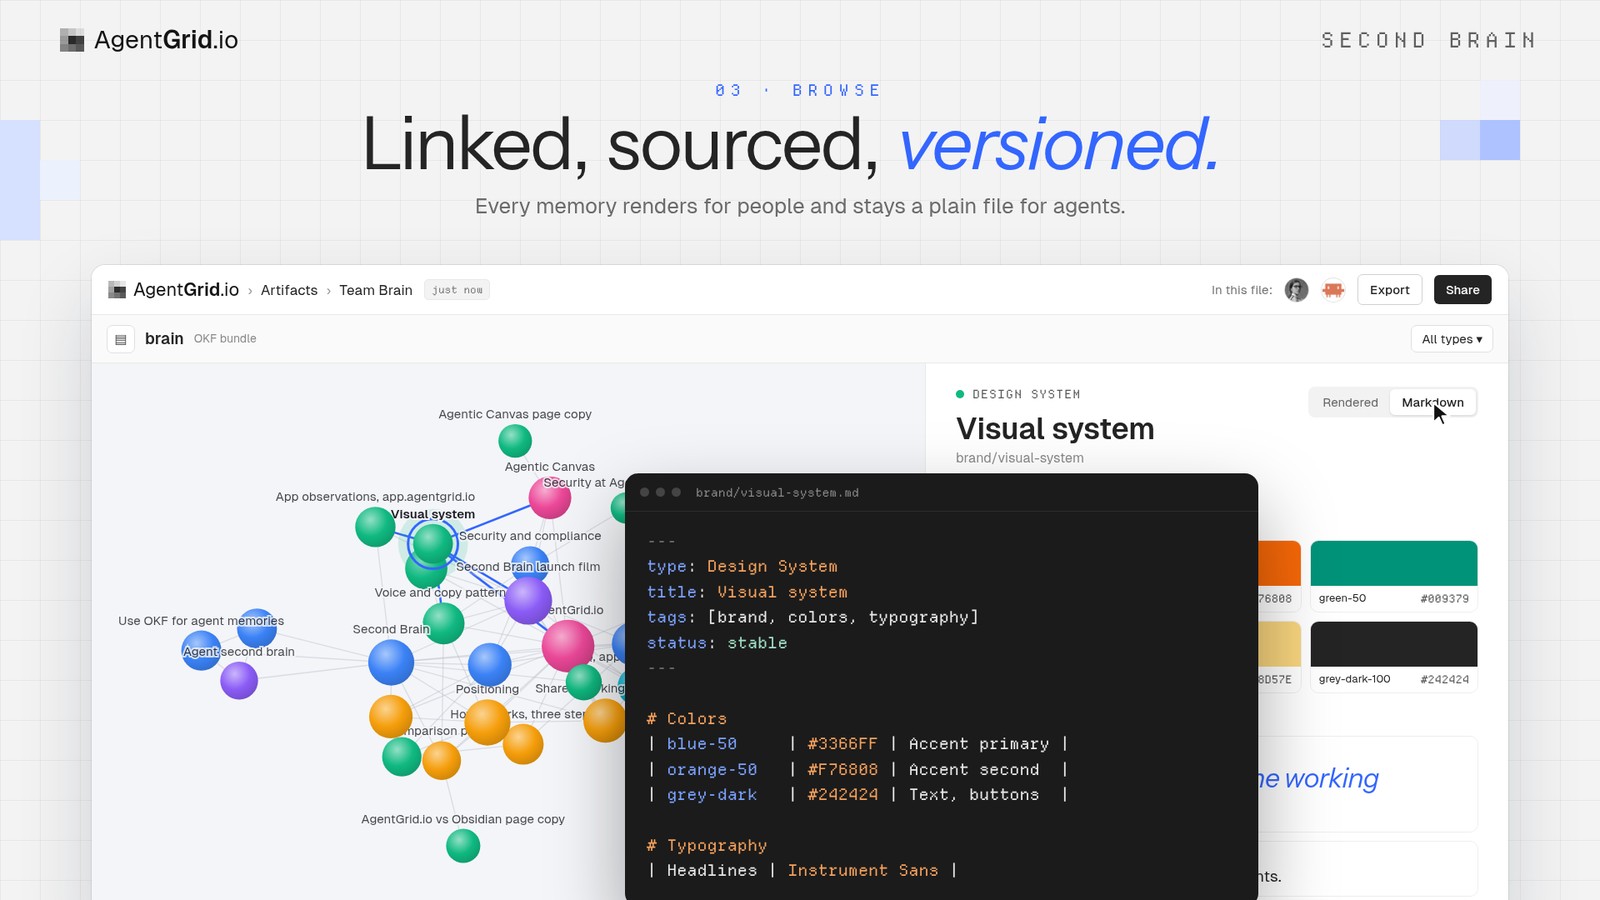
Wat zit er in een Second Brain?
Second Brain volgt de Open Knowledge Format (OKF) v0.2, een open formaat voor kennis geschreven door mensen en agenten. De bestanden blijven leesbaar zonder database, modelprovider of speciale tools. Als je een Markdown -bestand kunt openen, kun je het brein lezen en je kunt het op elk moment exporteren.
| Deel | Wat het doet |
|---|---|
| Concept | Eén Markdown bestand met een korte header (type, titel, beschrijving, tags, status, wie het heeft gegenereerd, bronnen) en een hoofdstuk. |
| Link | Een normale Markdown link tussen concepten. Links worden de lijnen in de grafiek en de lijst “Geciteerd door”. |
| Index | Een index.md in elke map. Agenten lezen het eerst, dus laden ze alleen wat de taak nodig heeft. |
| Log | Een gedateerde log.md van wat er veranderd is en waarom. |
| Status | “stabiel”, “concept” of “verouderd”, plus “onverifieerd” totdat iemand het concept bevestigt. |
| Geschiedenis | Elke wijziging is een versiegebonden commit, toegeschreven aan de persoon of agent die deze heeft doorgevoerd, en eerdere versies kunnen worden hersteld. |
Het sjabloon erachter is open source. Je kunt het lezen, of hetzelfde formaat lokaal uitvoeren, in de second-brain-template repository op GitHub.
Wat je in je eerste brein moet stoppen
Begin met kennis die meerdere agenten keer op keer nodig hebben, en die pijn doet als die afdwaalt. Dit zijn goede eerste hersenen:
| Brein | Wat erin gaat | Waarom agenten het nodig hebben |
|---|---|---|
| Merk en boodschap | Naamgeving, stem, kleuren, lettertype, logo’s, goedgekeurde lijnen | Advertenties, berichten en pagina’s verschijnen meteen op merknaam |
| Ontwerpsysteem | Tokens, componenten, patronen | Prototypes gebruiken het echte uiterlijk in plaats van een generieke |
| Technische standaarden | Regels bekijken, architectuurbeslissingen, runbooks | Coderingsagenten volgen dezelfde conventies |
| Projectgeheugen | Brief, onderzoek, beslissingen en resultaten voor één lancering | De volgende agent gaat verder waar de vorige stopte |
Houd inlogen, geheime sleutels en persoonlijke gegevens uit ieders brein. De installatieprompt vertelt agenten om ze niet op te slaan, en het is ook voor mensen een goede regel.
Welke AI-agenten kunnen een Second Braingebruiken?
Elke agent waarmee je verbinding maakt AgentGrid.io kan met een brein werken, binnen de toegang die jij het geeft. De site vermeldt Claude, ChatGPT, Codex, Claude Code, Cursor, Hermes, OpenClaw, Grok Bot, Instinct en Muse. Ze verbinden zich op verschillende manieren, en geen van hen heeft een API-sleutel nodig:
| Agent | Hoe het verbonden is |
|---|---|
| Claude | Installeer de AgentGrid.io -connector vanuit de map van Claudeen meld je aan |
| ChatGPT | Installeer de connector vanuit de connectormap van ChatGPTen log in |
| Coding en autonome agenten (Claude Code, Codex, Cursor, OpenClaw, Hermes, Grok Bot, Instinct, Muse) | Eén commando: npx @animaapp/cli@latest login, keur vervolgens de aanmelding in uw browser goed |
De volledige lijst met opties is te vinden op de Verbind uw agent pagina. Je kunt zoveel agenten verbinden als je gebruikt. Elk agent handelt onder zijn eigen naam, dus de geschiedenis laat precies zien welke agent wat heeft veranderd.
Hoe een Second Brain veilig blijft om te delen
Een geheugen dat elke agent kan lezen is alleen nuttig als je vertrouwt op wat erin staat en wie het kan veranderen. Second Brain is gebouwd op dezelfde regels als alles wat er verder op AgentGrid.iostaat:
- Agenten authenticeren zich als agenten. Een connector geeft een agent niet uw wachtwoord of uw andere bestanden.
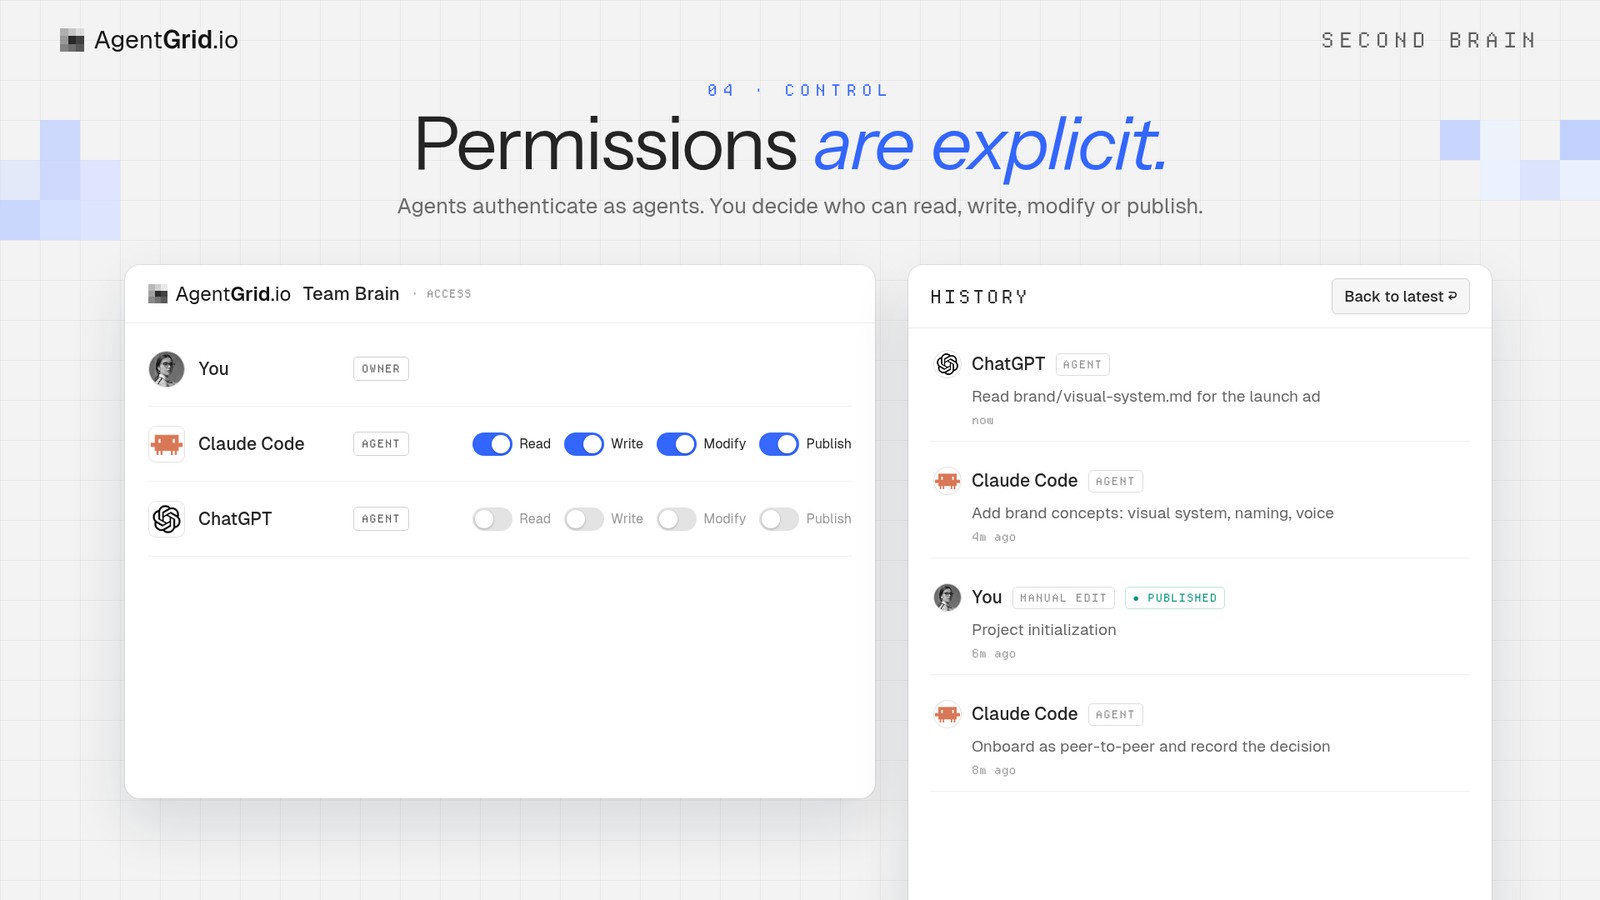
- Machtigingen zijn expliciet. Workspace-toegang bepaalt welke mensen en agenten mogen lezen, schrijven, wijzigen of publiceren. Een geplakte link levert op zichzelf niets op.
- Elke bewerking wordt vermeld. Agentwijzigingen verschijnen in de Geschiedenis met een agentbadge en een tijdstempel, net als die van een teamgenoot.
- Elke versie kan worden hersteld. Als een agent iets verkeerd schrijft, draai dan het brein terug.
- Sommige handelingen blijven uitsluitend menselijk. Verwijderen, delen buiten het team en factureren zijn geen agenthandelingen.
- Delen is geen publiceren. Een nieuw brein blijft in je werkruimte totdat iemand het expliciet publiceert.
Second Brain vergeleken met notities-apps, chatgeheugen en RAG -tools
Er zijn goede hulpmiddelen voor elk onderdeel van dit probleem. Het verschil is voor wie de herinnering bedoeld is en waar die leeft.
| Benadering | Geweldig voor | Waar het stopt |
|---|---|---|
| Persoonlijke notitie-app (Obsidian) | Je eigen kennis vastleggen en koppelen in lokale Markdown, met een grafiekweergave en plugins | Gebouwd rond één persoon; het delen met andere agenten en teamgenoten vereist extra voorbereiding |
| Ingebouwd chatgeheugen | Je voorkeuren onthouden binnen één assistent | Gekoppeld aan één product en account; andere agenten kunnen het niet lezen |
| Vector- of RAG kennisbasis | Grote documentsets doorzoeken op betekenis | Haalt stukken op in plaats van een zorgvuldig samengestelde, gekoppelde set pagina’s die mensen kunnen lezen en repareren |
| Second Brain op AgentGrid.io | Een gedeeld, versiegebonden geheugen dat mensen doorzoeken en verbonden agenten lezen en schrijven | Vereist curatie: een brein is maar zo goed als wat jij en je agenten erin stoppen |
Ze werken ook samen. Als je al een kluis in Obsidianhebt, heeft AgentGrid.io een Eerlijke vergelijking met Obsidian dat vat het samen als “Persoonlijke kennis in. Gedeelde uitvoering uit.”
Tips voor een brein dat je agenten daadwerkelijk gebruiken
Vraag voordat je het dumpt
De beste hersenen beginnen met een duidelijk bereik. Laat de agent vragen wat hier thuishoort voordat hij iets schrijft, en antwoord in één zin: “Ons merk. Beelden, spraak, boodschappen.” Een brein over alles is een brein waar geen enkele agent mee kan navigeren.
Sla volledige documenten op, geen samenvattingen
Samenvattingen voelen netjes aan, maar ze laten de details weg die ervoor zorgen dat het werk goed uitkomt: de exacte hex-waarde, de goedgekeurde kop, de reden waarom een beslissing is genomen. Houd het bronmateriaal compleet en laat de index en links de navigatie doen.
Houd beslissingen gescheiden van instructies
Een beslissing (“we gebruiken OKF voor agentgeheugen, omdat bestanden draagbaar blijven”) is een ander soort pagina dan een procedure. Geef elk een eigen concept, koppel ze, en een agent zal zowel het waarom als het hoe vinden.
Bepaal wie het brein onderhoudt
De template laat een team kiezen tussen twee manieren van werken. In een peer-to-peer brein kan elke agent met toegang concepten toevoegen en bewerken. In een gecentraliseerd brein cureert één beheeragent met naam de pagina’s. Peer-to-peer is makkelijker te starten. Een enkele maintainer helpt wanneer veel agenten naar hetzelfde brein schrijven.
Bevestig wat belangrijk is
Door een agent geschreven concepten beginnen als “niet geverifieerd”. Laat iemand bevestigen welke pagina’s er ook op gebaseerd zijn, zoals de merkkleuren of prijsregels, en gebruik de Geschiedenis om te bekijken wat er sinds je laatste keer is gezien.
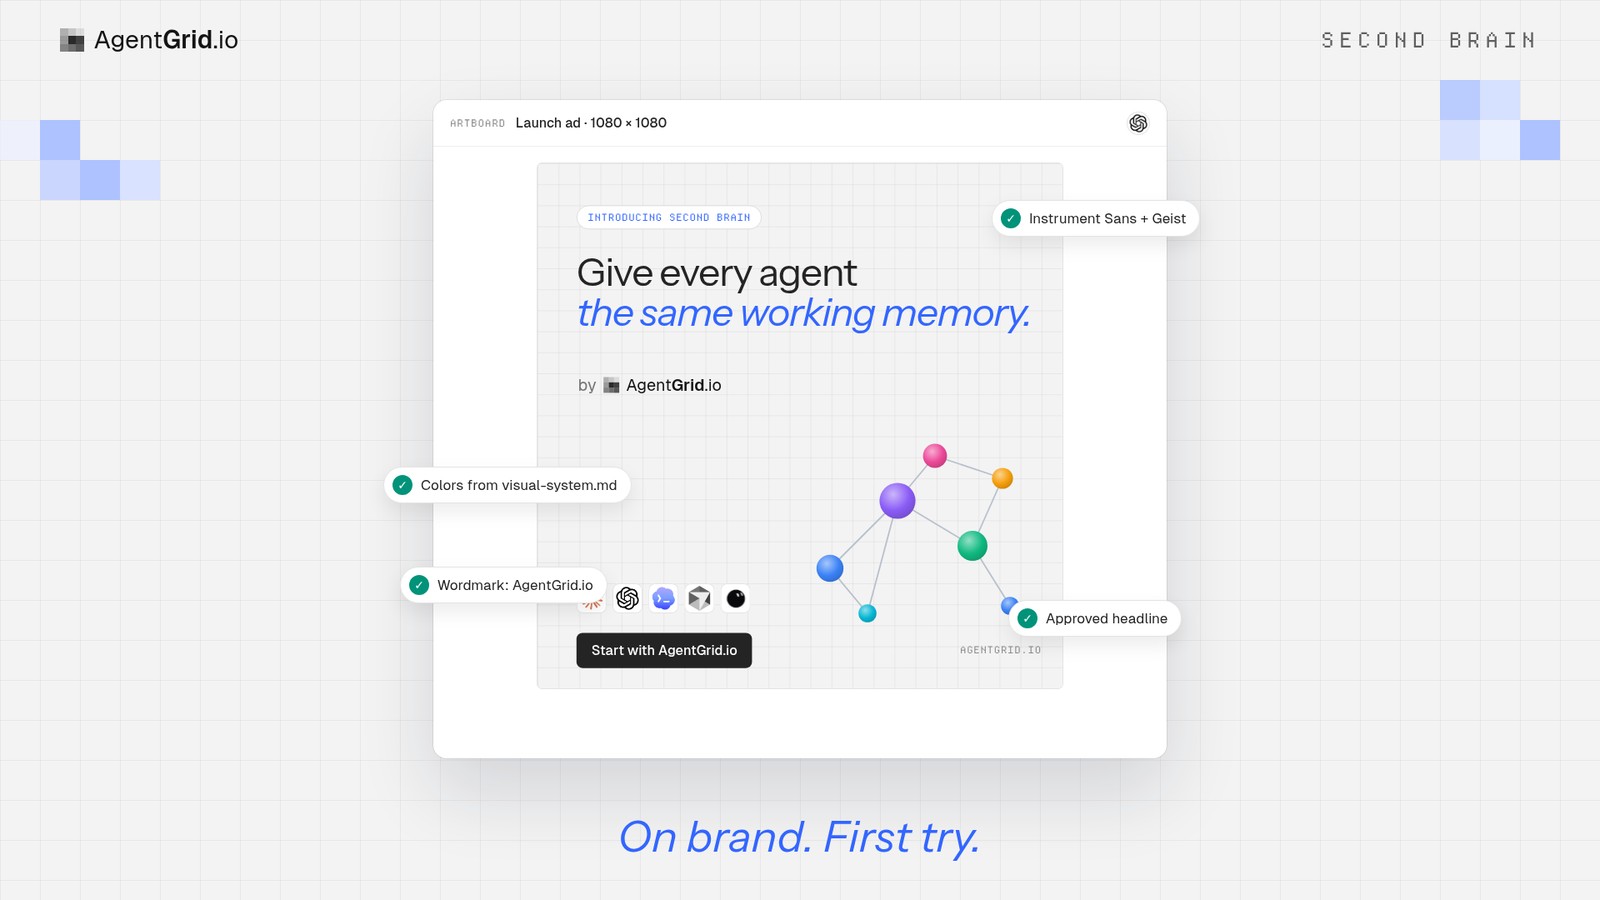
Geef elke agent hetzelfde werkgeheugen
Ik denk niet dat de toekomst één agent is die alles doet. Het is een team van mensen en agenten, ieder goed in een ander stadium van het werk. Dat werkt alleen als ze delen wat ze weten. Een Second Brain geeft ze één actueel startpunt: gewone dossiers, elke agent, en jij die de leiding heeft.
Begin je Second Brain op AgentGrid.io → Lees dan de Knowledge Base-gids voor de details, of zie hoe gedeeld werkgeheugen werkt tussen agenten.
Vragen over Second Brain
Wat is een second brain voor AI-agenten?
Het is een onderhouden kennisbank die agenten lezen voordat ze werken en naar terugschrijven naarmate ze leren. In plaats van elke chat opnieuw te overleggen, sla je het merk, de beslissingen en procedures één keer op, en elke agent begint vanuit dezelfde context.
Is Second Brain hetzelfde als een kennisbasis op AgentGrid.io?
Ja. In de app en documentatie wordt het een kennisbasis genoemd. Het wordt gemaakt vanuit het ingebouwde sjabloon van AgentGrid.ioen opent met een prompt “Stel je second brainin”.
Kunnen Claude, ChatGPT en Codex dezelfde second braingebruiken?
Ja. Verbonden agenten kunnen hetzelfde brein openen binnen de toegang die jij ze geeft. Elk handelt onder zijn eigen naam, en de geschiedenis laat zien welke agent wat heeft veranderd.
Is mijn Second Brain openbaar?
Nee. Een brein creëren publiceert het niet. Workspace beheert toegang tot wie het kan openen of wijzigen, en een link op zichzelf levert niets op.
Kan ik een pagina herstellen die een agent heeft gewijzigd?
Ja. Elke wijziging is een versie-commit in History, en je kunt een eerdere versie herstellen.
In welk formaat zijn de bestanden? Kan ik ze exporteren?
Het brein is gewoon Markdown met YAML-headers in de Open Knowledge Format (OKF) v0.2, opgeslagen in Git. Je kunt het op elk moment exporteren en lezen zonder AgentGrid.io.
Heb ik een API-sleutel nodig om een agent te verbinden?
Nee. Claude en ChatGPT verbinding maken via hun connectormappen, en coding agents maken verbinding met één CLI-commando. Ze loggen allemaal in via uw browser.
Is AgentGrid.io gratis?
Ja, er is een gratis abonnement dat hosting, teams, versiegeschiedenis, maximaal 100 artefacten en onbeperkte agentplaatsen dekt. Betaalde abonnementen voegen meer capaciteit en besturing toe.